

Содержание статьи
- Почему ChatGPT не принимает файл с таблицей?
- Почему нейросеть считает сумму не так, как Excel?
- Что делать, если ChatGPT путает столбцы?
- Откуда в ответе строки, которых нет в таблице?
- Почему ChatGPT не открывается в России и куда загрузить таблицу?
- Как подготовить таблицу к анализу нейросетью?
- Как проверить ответ нейросети формулой в Excel?
- Какие таблицы нельзя загружать в зарубежный чат?
- Сколько стоит анализ таблиц нейросетью и что нужно на старте?
- Жалоба, причина и первое действие: сводная таблица
- Когда с таблицей нужна помощь со стороны?
- Вопросы про таблицы и файлы в чате
- Источники
«Загрузил выгрузку продаж за квартал, попросил сумму по регионам, а она не сходится с Excel на сорок тысяч». С этой фразы начинается почти любой разговор про анализ таблиц нейросетью. Чаще всего виновата сама таблица, а нейросеть просто послушно посчитала то, что увидела: числа, записанные текстом, строку итогов внутри данных, два заголовка вместо одного.
Ниже пять жалоб, с которыми приходят чаще всего, и первое действие под каждую. Сразу про границы метода. Если таблица нужна для налоговой отчётности, зарплаты или договора, ответ чата годится только как черновик, а финальную цифру считает формула в Excel и человек, который за неё отвечает.
Почему ChatGPT не принимает файл с таблицей?
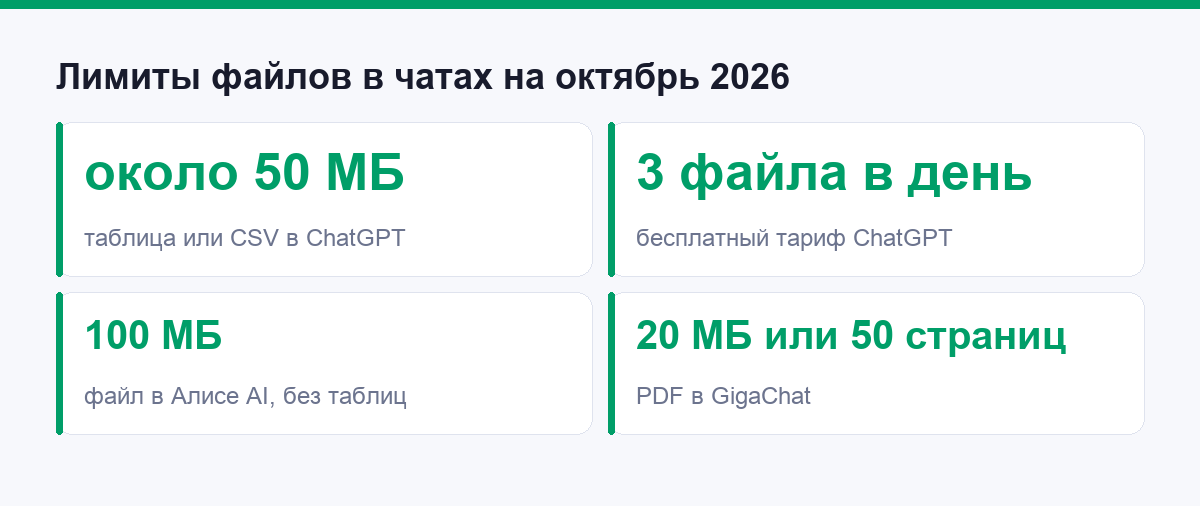
Кратко по делу: сначала проверьте размер и формат. По справке OpenAI таблицы и CSV принимаются примерно до 50 МБ, а бесплатный тариф пускает 3 загрузки в день (help.openai.com, проверено 28.10.2026). Если файл тяжелее или лимит исчерпан, чат откажет. Первый шаг: оставьте в копии файла только нужный лист и столбцы.
Жалоба звучит одинаково. Файл прикрепился, крутится значок загрузки, потом приходит ошибка или вежливое «не удалось прочитать файл». Причин обычно три, и все они проверяются быстро.
Первая причина в формате. ChatGPT принимает таблицы в XLSX, XLS, CSV и TSV. Файл из Google Таблиц или Numbers сначала нужно скачать в одном из этих форматов.
В обсуждениях на форуме OpenAI нередко встречаются жалобы на старый формат XLS, и решение там подсказывают сами пользователи. Пересохраните книгу в XLSX или выгрузите нужный лист в CSV.
Вторая причина в размере. Ориентир около 50 МБ для таблиц справка даёт с оговоркой «зависит от размера строки». Тяжёлой книгу делают не данные, а всё вокруг них: картинки, десяток служебных листов, сводные таблицы с кэшем, форматирование на миллион пустых строк. Копия файла, где оставлен один лист с данными, обычно весит заметно меньше.
Третья причина в квоте. Справка прямо пишет, что неудачная попытка загрузки иногда тоже засчитывается в лимит, а сколько попыток осталось, ChatGPT не показывает. Поэтому пять повторов подряд могут закончиться отказом уже из-за квоты. Если ошибка показывает время, когда можно повторить, дождитесь его.
Бывает и обратная ситуация, когда файл прочитался, а через час работы в том же чате модель вдруг перестала его видеть. Пользователи форума OpenAI в таких случаях советуют одно и то же. Новый чат, повторная загрузка, короткий запрос по одной задаче. Длинная переписка с десятком промежуточных таблиц мешает модели держать исходный файл в фокусе.
Почему нейросеть считает сумму не так, как Excel?
Кратко по делу: расхождение почти всегда сидит в данных, и найти его помогает вопрос «сколько строк ты сложил и по какому столбцу». В справке OpenAI по анализу данных прямо сказано, что код, результат и допущения нужно проверять до того, как на них опираться (help.openai.com, проверено 28.10.2026). Первое действие: попросить модель назвать число строк и сравнить его с Excel.
Когда ChatGPT анализирует таблицу, он обычно пишет и запускает небольшой код на Python. Код считает честно, но по тем правилам, которые модель вывела из файла сама. Если в данных есть ловушка, модель её не заметит и молча выдаст другую сумму.
Ловушек в офисных выгрузках немного, и они повторяются из файла в файл.
- Числа записаны текстом. «12 500 ₽» с пробелом и знаком рубля или «1250,50» с запятой код может прочитать как строку и пропустить, а может разобрать по своим правилам.
- Строка итогов внутри данных. Промежуточные «Итого по региону» складываются вместе с обычными строками, и сумма вырастает ровно на эти итоги.
- Скрытые строки и фильтры. Excel с включённым фильтром показывает сумму видимого, а файл в чат уходит целиком, со всеми скрытыми строками.
- Разные написания одного значения. «Москва», «москва» и «Москва » с пробелом на конце для кода три разных региона.
Первое действие под эту жалобу одно и то же. Попросите модель коротко отчитаться, сколько строк она взяла, какие исключила и по какому столбцу считала. Сравните это число с количеством строк в Excel.
Если они разные, причина найдена. Если одинаковые, ищите числа-текст и итоговые строки, и тут пригодится разбор того, почему формулы в Excel не работают: числа, сохранённые как текст, ломают и формулы, и нейросеть по одной и той же причине.
Что делать, если ChatGPT путает столбцы?
Кратко по делу: модель путает столбцы, когда у таблицы нет одной понятной строки заголовков. Справка OpenAI советует держать описательные заголовки в первой строке, одну запись на строку и не ставить несколько несвязанных таблиц на один лист. До любого расчёта попросите чат перечислить столбцы, которые он видит, с типом данных, и сверьте список с файлом.
Типичная картина выглядит так. Просите выручку по менеджерам, а получаете сумму по столбцу с номерами договоров. Или модель берёт «План» вместо «Факт», потому что оба столбца стоят под общей объединённой ячейкой «Март».
За путаницей почти всегда стоит шапка, которую рисовали для глаз человека. Две или три строки заголовков, объединённые ячейки, пустой столбец-разделитель, подписи вроде «Столбец1» после выгрузки из учётной системы. Человек понимает такую шапку по цвету и расположению, а код читает её буквально и подставляет первую строку как названия.
Первое действие делается одним запросом до основного вопроса. Попросите модель вывести список столбцов, которые она нашла, с типом данных в каждом и тремя примерами значений. Если в списке «Unnamed: 3» или числа там, где должны быть даты, шапку нужно чинить в самом файле.
Помогает и точная постановка задачи, где столбцы названы так, как они подписаны в таблице. Как собрать такой запрос от желаемого результата, показывает пример с письмом в статье про промпт для ChatGPT, и та же логика работает с таблицей.
Откуда в ответе строки, которых нет в таблице?
Кратко по делу: выдуманные строки появляются, когда модель отвечает по памяти разговора и ничего не пересчитывает. Справка OpenAI по анализу данных описывает расчёты на Python и просит проверять код и допущения (help.openai.com, проверено 28.10.2026). Лечится это просьбой посчитать заново кодом и назвать число строк в файле.
На форуме OpenAI эту жалобу формулируют по-разному. Модель показала двадцать шесть строк из тридцати пяти, придумала клиента, которого в выгрузке нет, или уверенно назвала «топ-5 товаров», хотя половины этих товаров нет в файле. Механизм у всех трёх случаев общий.
Языковая модель умеет писать правдоподобный текст, и таблица в ответе тоже текст. Когда расчёт не запускался, модель достраивает ответ по образцу, и получаются строки, похожие на настоящие. Откуда берутся такие уверенные выдумки и как их ловить, объясняет разбор почему нейросеть выдумывает факты.
Поэтому в запросе полезно сразу задавать правила работы с файлом. Например, так.
- «Считай только по загруженному файлу, ничего не добавляй от себя».
- «Перед ответом напиши, сколько строк и столбцов в таблице».
- «Если значения нет в файле, так и скажи, не подставляй похожее».
- «Покажи код, которым считал».
Четвёртый пункт особенно полезен. Даже если читать Python вы не умеете, по коду видно, какой столбец взят и стоит ли там фильтр. А число строк сверяется с Excel за секунду.
Почему ChatGPT не открывается в России и куда загрузить таблицу?
Кратко по делу: ChatGPT официально не поддерживает Россию, её нет в списке стран сервиса (help.openai.com, проверено 28.10.2026). Из доступных у нас сервисов Алиса AI принимает в чат один файл DOC, DOCX, PDF или TXT до 100 МБ, таблиц в списке нет (alice.yandex.ru, 28.10.2026). Поэтому сначала решите, нужен ли расчёт в чате вообще.
Справка OpenAI предупреждает, что доступ из стран вне списка может закончиться блокировкой или приостановкой аккаунта. Способы обхода мы не описываем. Выбирать приходится среди доступных в России сервисов: какой из них справится с вашей задачей?
У российских чатов свои лимиты, и они строже.
| Сервис | Что указано в справке | Таблицы XLSX и CSV |
|---|---|---|
| Алиса AI | один файл DOC, DOCX, PDF, TXT до 100 МБ за сообщение | в справке не указаны |
| GigaChat | TXT до 1 МБ, PDF до 20 МБ или первые 50 страниц, запрос до 4000 символов | в справке не указаны |
| ChatGPT (официально в РФ недоступен) | XLSX, XLS, CSV, TSV примерно до 50 МБ | да |
Данные Алисы AI взяты из справки о файлах в чате, данные GigaChat из FAQ сервиса (страница изменена 01.06.2026), проверено 28.10.2026.
Отсюда практичный ход, который подходит почти для любой офисной задачи. Отдавайте нейросети описание таблицы вместо самих данных и просите формулу.
Например, «в столбце B регион, в столбце D сумма, нужна сумма по Москве за март, дата в столбце A». GigaChat или Алиса AI выдадут формулу, вы вставите её в Excel, и данные вообще не покинут компьютер. Какие ещё сервисы доступны из России для рабочих задач, подскажет соседний материал о российских нейросетях для работы.
Как подготовить таблицу к анализу нейросетью?
Кратко по делу: подготовка таблицы снимает большую часть жалоб из этого разбора. Справка OpenAI по анализу данных называет три правила: описательные заголовки в первой строке, одна запись на строку, без пустых строк, столбцов, которые рвут данные, и нескольких несвязанных таблиц на листе. Сюда же стоит добавить чистку персональных данных и перевод чисел из текста в формат «Числовой».
Готовить лучше копию, а рабочий файл оставить как есть. Порядок такой.
- Сохраните копию книги и удалите из неё всё, кроме листа с данными.
- Сведите шапку к одной строке, разъедините объединённые ячейки, дайте столбцам короткие понятные названия.
- Уберите строки «Итого», пустые строки и столбцы-разделители.
- Снимите фильтры и проверьте, нет ли скрытых строк.
- Переведите числа и даты в числовой формат, уберите из ячеек знак рубля и лишние пробелы.
- Удалите или замените кодами столбцы с ФИО, телефонами, почтой и паспортными данными.
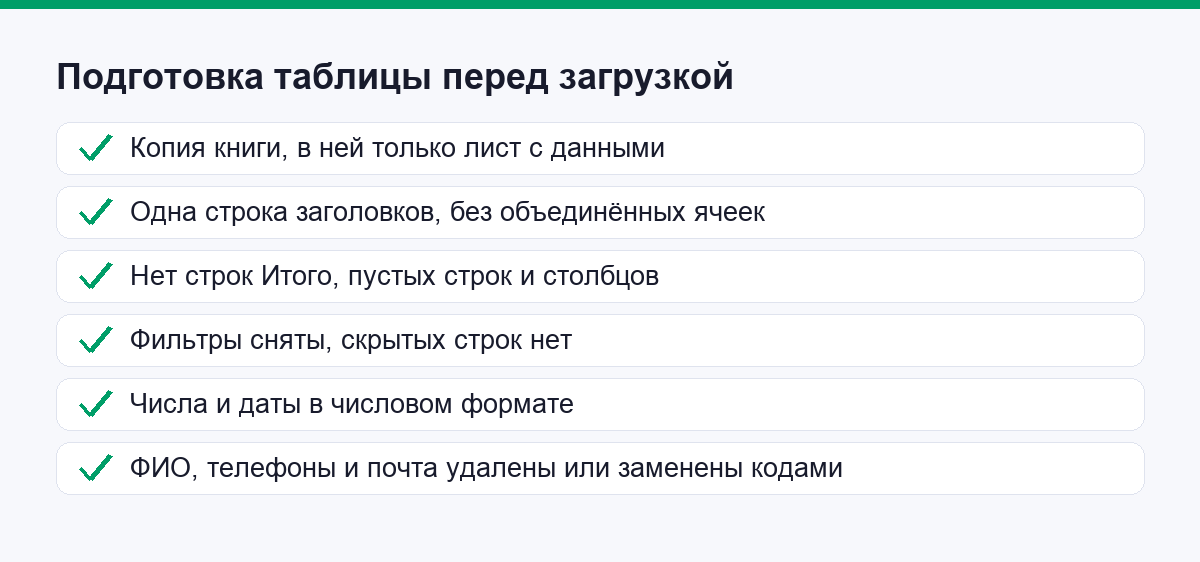
Пятый шаг выглядит мелочью, хотя именно числа, записанные текстом, дают расхождения из второй жалобы. Если таблица большая и в ней тысячи строк, разобраться с её устройством помогут приёмы из материала о том, как упорядочить большой объём данных в Excel. После такой чистки файл обычно ещё и становится заметно легче, что закрывает и первую жалобу про отказ загрузки.
Как проверить ответ нейросети формулой в Excel?
Кратко по делу: каждое число из ответа нейросети, которое уйдёт в отчёт, пересчитывается в Excel. Для сумм с условиями подходит функция СУММЕСЛИМН, она принимает до 127 пар диапазонов и условий (support.microsoft.com, проверено 28.10.2026). Обычно хватает трёх формул, и проверка короткая.
Пересчитывать всё подряд не нужно. Достаточно трёх контрольных точек, и если они сошлись, остальному ответу можно доверять больше. Четвёртая нужна, когда в ответе целая таблица по группам.
- Число строк. Формула =СЧЁТЗ(A:A) по столбцу без пропусков, минус строка заголовка. Сравните с тем, что назвала модель.
- Общая сумма. =СУММ(D:D) по столбцу с деньгами. Если не совпало, ищите числа, сохранённые как текст, и строки итогов.
- Одна группа. =СУММЕСЛИМН(D:D; B:B; «Москва») для любого региона, менеджера или месяца из ответа. Совпала одна группа, значит, модель правильно поняла столбцы.
- Срез целиком. Если в ответе таблица по группам, соберите сводную таблицу и сравните строки глазами.
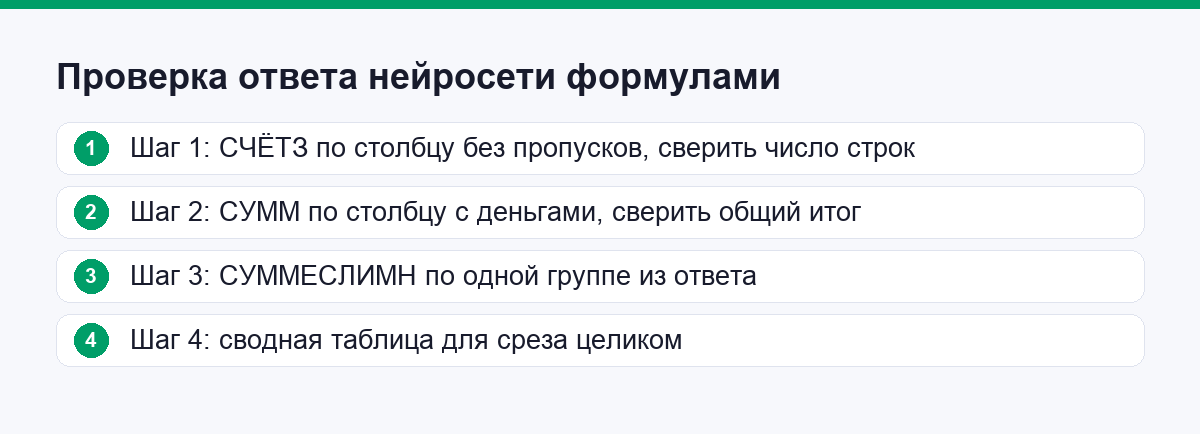
Сводная таблица в этой роли работает как второй независимый расчёт. Если сводные ещё не строили, начните с пошаговой инструкции по сводным таблицам в Excel. Общий подход к проверке спорных цифр, логики и источников в ответах чата описан отдельно, в статье о том, как проверять ответы нейросети.
Если расхождение осталось после всех трёх шагов, верните его модели как вопрос. «В Excel сумма по Москве 1 245 000, у тебя 1 285 000, найди строки, которые дают разницу». Такой запрос заставляет модель искать конкретные строки, и часто она сама находит дубль или итог внутри данных.
Какие таблицы нельзя загружать в зарубежный чат?
Кратко по делу: нельзя отправлять таблицы с персональными данными клиентов, сотрудников и кандидатов. Часть 5 статьи 18 закона 152-ФЗ не допускает при сборе данных записывать, систематизировать и хранить персональные данные граждан России с использованием баз данных за рубежом, кроме отдельных исключений (consultant.ru, редакция от 26.07.2026, проверено 28.10.2026). Такие столбцы удаляются из копии файла до загрузки.
Персональными данными закон называет любую информацию, которая прямо или косвенно относится к конкретному человеку. В офисной таблице это ФИО, телефоны, почта, адреса, должность рядом с фамилией, зарплата, данные паспорта. Выгрузка клиентской базы или зарплатной ведомости в зарубежный чат-бот как раз попадает под этот риск. Прямого разъяснения Роскомнадзора именно про чат-боты мы не нашли, поэтому говорим об этом как о риске, который компания берёт на себя.
Что безопасно отдавать. Обезличенные данные, где вместо имени код клиента, агрегаты вроде выручки по месяцам и регионам, описание структуры таблицы без самих значений. Коммерческая тайна, пароли и внутренние документы тоже под вопросом, полный список собран в памятке о безопасности рабочих данных в ChatGPT.
Есть и вторая сторона. На потребительских тарифах ChatGPT, по справке OpenAI, содержимое переписки может использоваться для обучения моделей, если пользователь не отключил это в настройках Data Controls. Для коммерческой тайны вроде маржи по клиентам или цен закупки этого уже достаточно, чтобы подумать дважды.
Сколько стоит анализ таблиц нейросетью и что нужно на старте?
Кратко по делу: начать можно бесплатно. Бесплатный тариф ChatGPT ограничен 3 загрузками файлов в день, платный Plus стоит $20 в месяц (help.openai.com, проверено 28.10.2026), но оплата из России официально не предусмотрена. Веб-чат GigaChat, по справке сервиса, бесплатный, нужен вход через Сбер ID. Главное на старте всё равно Excel или другой табличный редактор для проверки.
Для типичной офисной задачи вроде разбора выгрузки продаж раз в неделю набор получается скромный. Табличный редактор, в котором вы уже работаете, доступный чат для формул и вопросов по структуре и навык проверки, описанный выше.
Платный тариф нужен, когда файлов много каждый день или таблицы тяжёлые. Общий потолок загрузок справка ChatGPT называет так: до 80 файлов за 3 часа, а в часы пик OpenAI может его снижать. Чем отличаются тарифы по задачам, разобрано в сравнении бесплатного и платного ChatGPT.
Частая ошибка новичка на старте выглядит так. Человек покупает доступ, загружает необработанную выгрузку и разочаровывается после первого неверного итога. Подготовка таблицы и проверка формулой дают больше, чем смена тарифа.
Жалоба, причина и первое действие: сводная таблица
Кратко по делу: пять жалоб сводятся к трём корням. Файл не подходит по размеру или формату, таблица устроена для глаз человека и плохо читается кодом, или модель ответила без расчёта. Под каждую жалобу ниже одно первое действие, которое стоит сделать раньше любых других попыток, включая смену сервиса или тарифа.
| Жалоба | Частая причина | Первое действие |
|---|---|---|
| «Файл не грузится» | размер больше 50 МБ, старый XLS, исчерпана дневная квота | оставить один лист, пересохранить в XLSX или CSV |
| «Считает не так» | числа текстом, строки «Итого», скрытые строки | спросить, сколько строк сложено, сверить с Excel |
| «Путает столбцы» | шапка в несколько строк, объединённые ячейки | попросить список столбцов с типами данных |
| «Выдумывает строки» | ответ без расчёта, по памяти разговора | потребовать пересчёт кодом и число строк |
| «В России не открывается» | ChatGPT официально не поддерживает Россию | взять GigaChat или Алису AI и просить формулу |
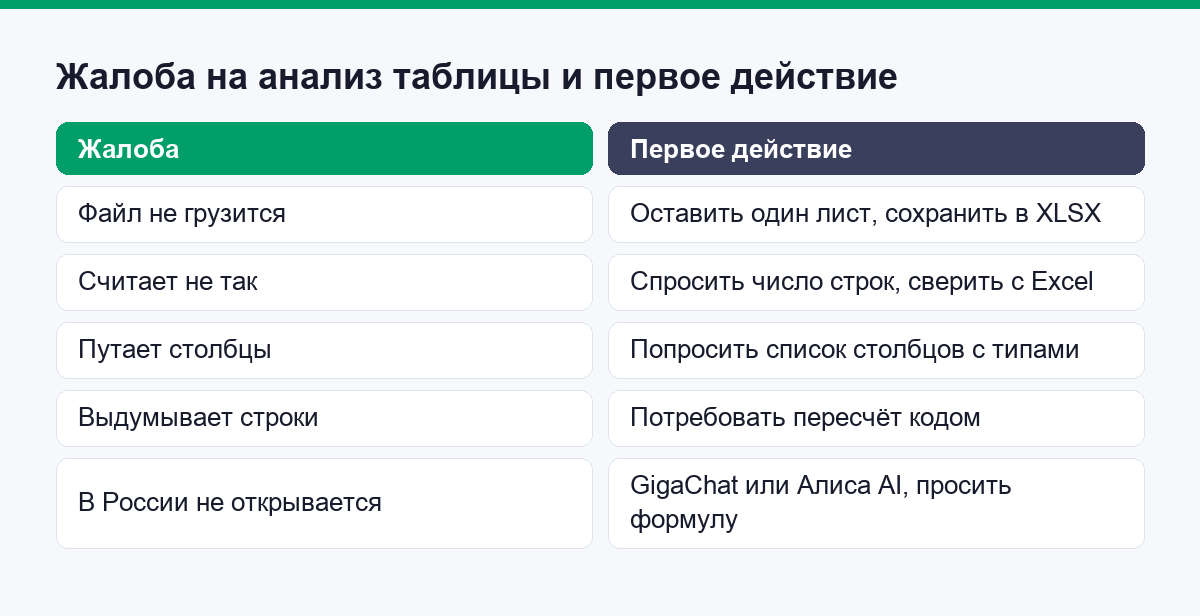
Если жалоба повторяется после первого действия, переходите ко второму из соответствующего раздела. Обычно хватает двух шагов, а третий нужен редко.
Когда с таблицей нужна помощь со стороны?
Кратко по делу: помощь специалиста нужна, если цифра уйдёт в налоговую, зарплатную или договорную документацию, если расхождение не нашлось после трёх контрольных формул или если таблица содержит персональные данные, которые некуда обезличить. В этих случаях ответ нейросети остаётся черновиком, а решение принимает человек, который отвечает за результат.
Есть жалобы, которые говорят о задаче, переросшей чат. Сумма не сходится после проверки строк, общей суммы и одной группы. Данные лежат в нескольких файлах, которые нужно связывать по ключу, а ключи записаны по-разному. Отчёт собирается каждую неделю, и каждый раз руками.
Тогда выгоднее один раз позвать аналитика или бухгалтера и построить нормальную модель в Excel, базе данных или учётной системе.
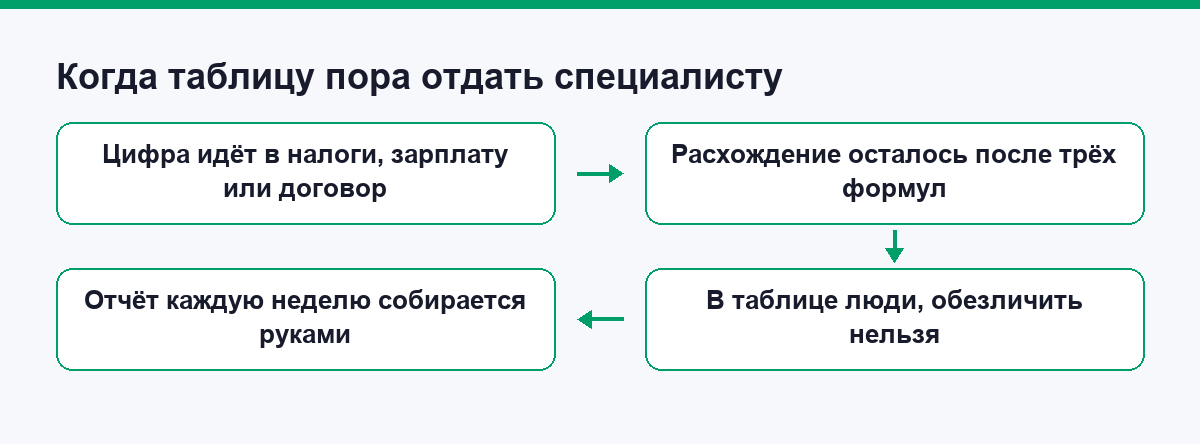
Вторая граница юридическая. Если таблица описывает людей и обезличить её нельзя, вопрос о том, можно ли вообще обрабатывать её во внешнем сервисе, решает юрист или ответственный за персональные данные в компании. Где ещё нейросети нельзя доверять финальное слово, разобрано в материале о задачах, которые нельзя поручать ChatGPT.
Третья граница касается отчёта для руководства. Нейросеть подскажет, какие срезы посмотреть, но сам отчёт, который читают и по которому решают, лучше собирать в Excel, и тут выручат приёмы отчёта, который понимает руководитель. А если таблицы только часть большой задачи по внедрению нейросетей, начать стоит с обзора для малого бизнеса.
Если хочется системно освоить нейросети для работы, есть курс «Нейросети для работы и бизнеса».
Вопросы про таблицы и файлы в чате
Можно ли вставить таблицу в чат текстом вместо файла?
Можно, если строк немного. Скопированный из Excel диапазон вставляется в поле запроса как текст с табуляцией, и модель его читает. Для GigaChat держите в голове ограничение в 4000 символов на запрос, это несколько десятков коротких строк. Большие объёмы удобнее отдавать файлом или просить формулу.
Почему один и тот же запрос даёт разные итоги?
Модель каждый раз заново решает, как читать файл и какой код написать. Если таблица неоднозначная, два запуска могут по-разному обработать текстовые числа или итоговые строки. Чистая таблица и запрос с названиями столбцов почти убирают этот разброс.
Читает ли ChatGPT таблицу внутри PDF?
Справка OpenAI говорит, что в PDF модель видит и текст, и изображения, включая графики. Но таблица из PDF при разборе может потерять границы ячеек, и столбцы съедут. Если есть исходный XLSX, отправляйте его, а PDF оставьте для документов.
Сколько листов книги модель видит?
Если листов несколько, модель может взять для расчёта не тот, который вы имели в виду. Назовите нужный лист в запросе прямо, а надёжнее оставьте в копии файла только его. Тогда и вопрос о том, какие данные ушли в расчёт, снимается сам собой.
Источники
- OpenAI Help Center: Uploading files and audio to ChatGPT (лимиты размера и загрузок, проверено 28.10.2026)
- OpenAI Help Center: Data analysis with ChatGPT (подготовка таблиц, проверка кода, 28.10.2026)
- OpenAI Help Center: ChatGPT supported countries (список стран, 28.10.2026)
- OpenAI Help Center: What is ChatGPT Plus (цена тарифа, 28.10.2026)
- Алиса AI: файлы в чате (форматы и размеры, 28.10.2026)
- GigaChat: частые вопросы (лимиты запроса и файлов, 28.10.2026)
- Microsoft Support: функция СУММЕСЛИМН (синтаксис и число условий, 28.10.2026)
- Федеральный закон 152-ФЗ «О персональных данных», КонсультантПлюс (ст. 3, ст. 18, редакция от 26.07.2026)