


Содержание статьи
- Каким советам учили новичков год назад?
- Что изменилось в нейросетях с длинным текстом и файлами?
- Что изменилось в нейросетях с рассуждением и встроенным поиском?
- Как за год поменялись голос, картинки и память?
- Какие советы устарели и чем их заменили?
- Что делать тем, кто учился по старым гайдам?
- Что осталось прежним в работе с нейросетями?
- Кто отвечает за результат и что нельзя вводить в чат?
- Доступны ли зарубежные сервисы в России?
- Как не отстать в следующий раз?
- Сколько стоит начать и какие ошибки делают чаще всего?
- Вопросы про перемены в работе с нейросетями
- Источники
Всё, что изменилось в нейросетях за год, сводится к одному движению — сервисы забрали себе то, что раньше пользователь делал руками. В ChatGPT длинный текст больше не нужно резать на куски, файл остаётся в диалоге и доступен назавтра, поиск по интернету включён по умолчанию, глубина рассуждения переключается ползунком. Часть советов из гайдов позапрошлого сезона теперь мешает работе, и об этом написали сами разработчики в своей документации.
Разбор ниже собран по официальным журналам обновлений и справочным страницам, каждая из них открыта 3 сентября 2026 года. Чего в тексте нет — прогнозов на будущее, номеров версий и оценок на глаз.
Дальше по порядку: какие приёмы разработчики отменили и с какой даты, что поменялось в контекстном окне, файлах, рассуждении, поиске и голосе. Следом таблица со старыми советами и их нынешними заменами, список привычек для переучивания и вторая таблица с тем, что за год не сдвинулось ни на шаг. Отдельно про официальную доступность зарубежных сервисов в России и про то, где смотреть журналы обновлений, чтобы не отстать снова.
Каким советам учили новичков год назад?
Ситуация на сегодня: набор приёмов из гайдов позапрошлого сезона строился вокруг слабых мест тогдашних моделей. Длинные заклинания в начале промпта, требование «проверь тщательно», ручная нарезка документа на куски по три страницы, отдельный сервис под расшифровку и отдельный под картинки. Каждый приём чинил конкретное ограничение, и большую часть этих ограничений разработчики за год закрыли.
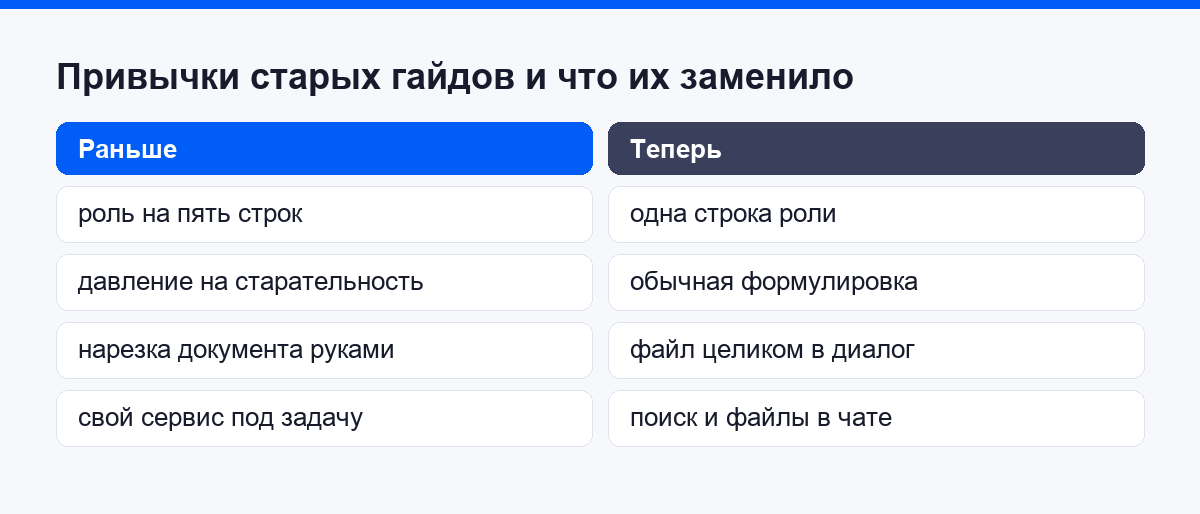
Типовой промпт из популярного гайда открывался регалиями. «Ты эксперт мирового уровня с двадцатилетним опытом», дальше пять строк про тон, аудиторию и формат, и только потом сама задача. Логика была понятной. Модель хуже держала инструкцию, и роль работала как костыль.
Второй слой инструкций давил на старательность. Здесь жили «проверь тщательно», «не ленись», «используй все инструменты» и «подумай шаг за шагом», и на моделях того поколения эти формулировки правда поднимали качество ответа.
Третья привычка касалась длинных документов. Договор на сорок страниц резали на части по три страницы, скармливали по очереди и вручную сшивали пересказы. Иначе диалог обрывался на середине.
Четвёртая привычка отправляла человека собирать зоопарк сервисов. Один инструмент для расшифровки аудио, второй для картинок, третий для поиска по вебу, четвёртый для таблиц. Никто не умел всё, и это считалось нормой. Как выглядит рабочий промпт без регалий, показывает пара «до и после» в разборе промпта от результата.
Что изменилось в нейросетях с длинным текстом и файлами?
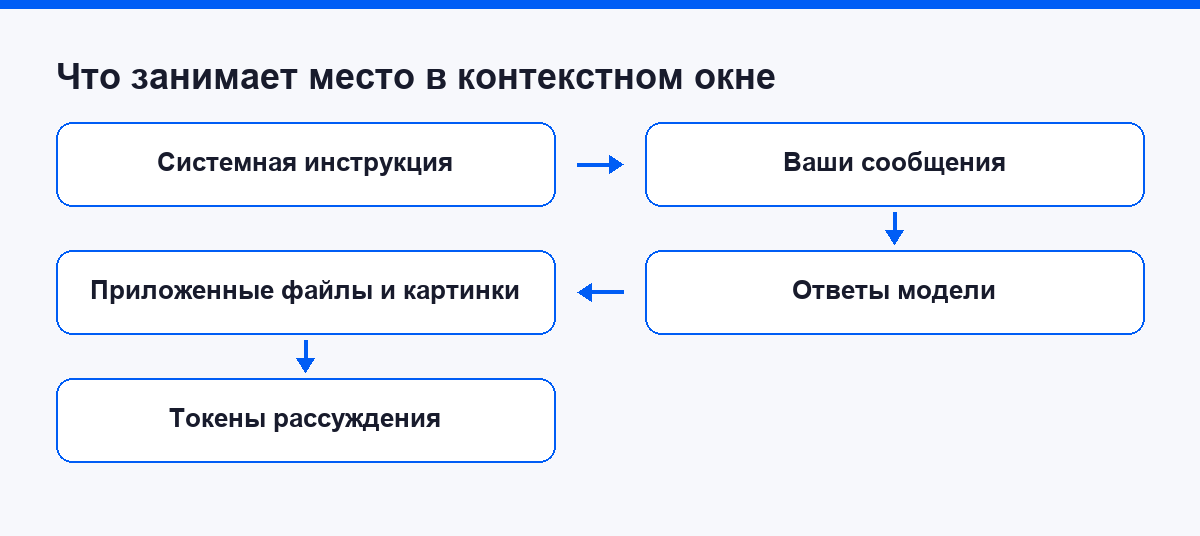
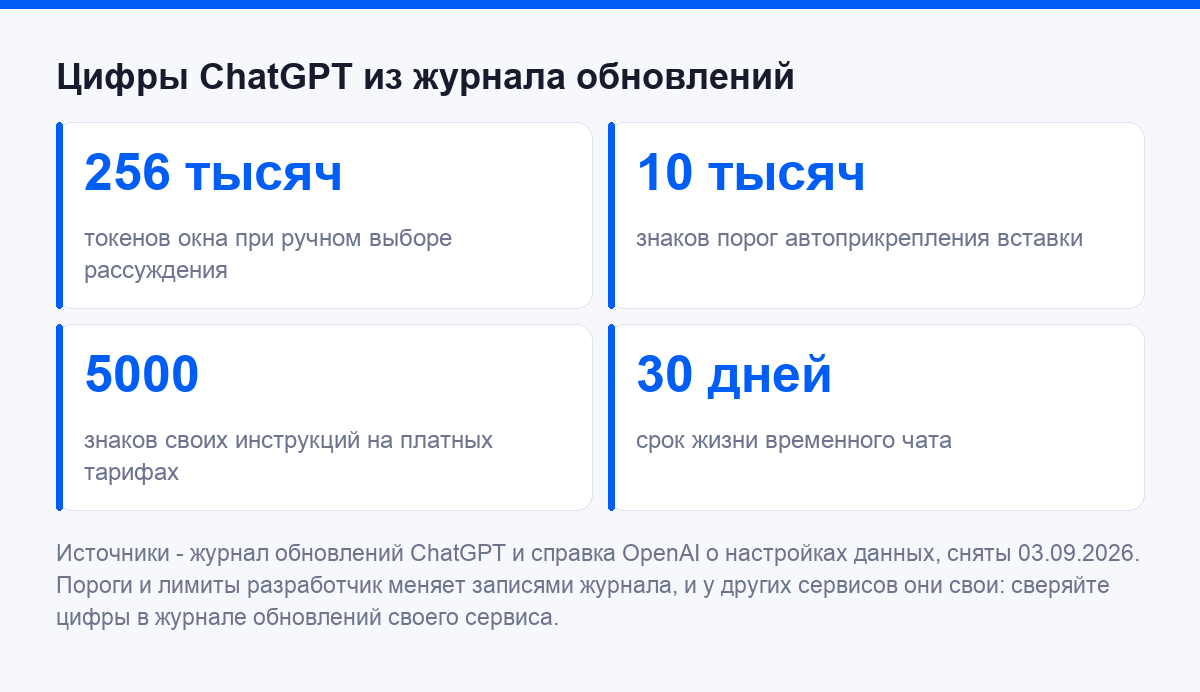
Ситуация на сегодня: чат сам превращает вставку длиннее 10 тысяч знаков в приложенный файл, чтобы она не съела контекстное окно целиком. При ручном выборе рассуждающего режима окно диалога в ChatGPT доходит до 256 тысяч токенов. Обе записи датированы и лежат в журнале обновлений: 22 июня и 20 февраля 2026 года. Проверено 3 сентября 2026 года.
Автоприкрепление больших вставок разработчик описывает прямым текстом. Механику ввели 25 марта 2026 года, чтобы крупная вставка не расходовала всё контекстное окно. 22 июня 2026 года её распространили на бесплатные тарифы и подняли порог с 5 до 10 тысяч знаков, 4 августа того же года она дошла до корпоративных и учебных тарифов. Ручная нарезка документа после этого потеряла смысл в самом массовом сценарии.
Размер рабочей памяти диалога вырос и у второго крупного разработчика. В документации Anthropic по контекстным окнам часть моделей заявлена с окном в 1 млн токенов, остальные с окном в 200 тысяч токенов. В один запрос помещается до 600 изображений или страниц PDF, а у моделей с окном в 200 тысяч этот предел равен 100. Цифры сняты со страницы 3 сентября 2026 года и меняются с каждым поколением моделей, поэтому сверяйте их прямо там.
Токен, контекст, окно — слова, которые дальше встретятся ещё десяток раз. Их короткие определения лежат в разборе базовых терминов.
На стороне разработчиков появилось серверное сжатие. В документации Anthropic по контекстным окнам описано, как сервер сам пересказывает ранние части разговора, и диалог продолжается за пределом окна. Дату введения разработчик не указывает, страница проверена 3 сентября 2026 года. Работает сжатие пока в бета-режиме на стороне API, кнопки в чате для него нет, но задачу оно закрывает ту же, которую раньше человек делал вручную.
И сразу честная оговорка из документации Anthropic. С ростом числа токенов точность и полнота ответа падают, у эффекта есть название context rot. Отбирайте то, что кладёте в диалог, и не сваливайте туда всё подряд в надежде, что модель разберётся сама.
Файлы перестали быть разовым вложением. 23 марта 2026 года в чате появилась библиотека, куда автоматически сохраняется всё загруженное и созданное. 7 августа 2026 года сохранённый файл стало можно подключить к новому диалогу без повторной загрузки, тогда же разработчик заявил, что ответы держатся ближе к содержимому приложенных документов. 13 августа 2026 года при подключённом плагине в библиотеке стали видны файлы из Google Drive.
Что изменилось в нейросетях с рассуждением и встроенным поиском?
Ситуация на сегодня: выбор «какая модель» сменился выбором «сколько думать», а инструменты веб-поиска, по справке OpenAI, включены по умолчанию для всех моделей OpenAI. Кнопка рассуждения дошла до бесплатных тарифов записью журнала от 14 августа 2026 года, а ползунок глубины ответа появился 6 августа 2026 года. Обе страницы открыты 3 сентября 2026 года.
Переключатель времени на размышление появился в поле ввода ещё 17 сентября 2025 года и тогда работал только на платных тарифах. Дальше журнал показывает движение в одну сторону. 17 марта 2026 года выбор модели упростили, 10 июня 2026 года он свёлся к уровням рассуждения вместо имён моделей.
Гнаться за именем версии больше не нужно. Вопрос свёлся к тому, сколько времени модель тратит на задачу, и глубокий режим стоит включать там, где важна цепочка шагов: разбор договора, расчёт, план работ, поиск ошибки в таблице.
По руководству OpenAI по рассуждающим моделям токены рассуждения занимают место в контекстном окне и оплачиваются как вывод, а на стороне Anthropic thinking-токены точно так же входят в лимит окна. На задаче «перепиши абзац покороче» глубокий режим даёт минус по скорости и по расходу и ничего не добавляет по качеству.
Со встроенным поиском аккуратность нужна двойная. Справка OpenAI говорит, что без включённых инструментов ответ опирается только на данные обучения, а сами инструменты включены по умолчанию, и с поиском модель ссылается на живые источники. У журнала обновлений Claude отдельных записей про веб-поиск за последние двенадцать месяцев не нашлось, поэтому приписывать это изменение всем разработчикам сразу нельзя.
Проверяйте, есть ли в ответе ссылки, по которым можно кликнуть. Ответ на свежий вопрос без единого кликабельного адреса стоит перепроверить самому, даже если сервис заявляет поиск по умолчанию.
Как за год поменялись голос, картинки и память?
Ситуация на сегодня: голос перестал быть отдельным режимом и работает внутри обычного диалога с 25 ноября 2025 года, а у новой модели диктовки частота ошибок в словах оказалась ниже как минимум на 10 процентов относительно прежней на основных проверенных языках (запись от 26.06.2026). Лимит пользовательских инструкций на платных тарифах подняли с 1500 до 5000 знаков 15 июля 2026 года. Источник у всех трёх записей один — журнал обновлений, проверено 3 сентября 2026 года.
Голосовой ввод из отдельной кнопки превратился в обычный способ набора. 8 июля 2026 года голосовые модели научились слушать и говорить одновременно, поэтому перебивать собеседника стало естественно. 7 августа 2026 года голос дотянулся до загруженных файлов и проектов. Новая модель диктовки, по записи от 26 июня 2026 года, ошибается в словах как минимум на 10 процентов реже прежней на основных проверенных языках.
Год назад приложенную картинку нельзя было переспросить: правка сообщения перезапускала всю ветку. 27 февраля 2026 года это починили, и картинка стала жить в диалоге наравне с текстом. До этого, 16 декабря 2025 года, обновили сам генератор изображений, а 21 апреля 2026 года генерация получила режим с обдумыванием результата до отрисовки. Иллюстрации из веба подмешиваются в ответы с 21 ноября 2025 года, а 12 мая 2026 года это дошло до бесплатного тарифа.
Сводка памяти долго оставалась чёрным ящиком. Открыли её 12 июня 2026 года: показанную сводку стало можно удалить вместе с отключением памяти, а отдельные строки править прямо в ней. 27 августа 2026 года свои настройки получил и временный чат. У Anthropic линия та же, журнал обновлений Claude отмечает память из истории чатов для всех пользователей 2 марта 2026 года и переход к отдельным записям по категориям 10 июля 2026 года.
Длинный вопрос теперь можно продиктовать поверх приложенного файла и не набирать его руками. Память чистите точечно, выключать её целиком уже не обязательно. А лимит пользовательских инструкций на платных тарифах с 15 июля 2026 года равен 5000 знаков, и в него помещается целый рабочий регламент, куда раньше влезала пара строк.
Какие советы устарели и чем их заменили?
Ситуация на сегодня: восемь советов из старых гайдов документация разработчиков сегодня либо переписала, либо отменила прямо. В таблице напротив каждого стоит нынешняя формулировка и название страницы, откуда она взята, а адреса собраны в блоке «Источники». Сверять удобно построчно: открыли источник, сравнили с тем, как работаете вы, поправили привычку. Все страницы открыты 3 сентября 2026 года.
| Совет из старых гайдов | Что говорит документация сегодня | Дата и источник |
|---|---|---|
| Начинай с «ты эксперт мирового уровня» | Роль в системной инструкции работает, и достаточно одного предложения; официальный пример роли занимает ровно строку | Руководство по промптингу Anthropic, проверено 03.09.2026 |
| Дави на старательность: «проверь тщательно», «не ленись» | При переходе на новые модели такие формулировки просят убрать: модели инициативнее и от старых инструкций делают лишнюю работу | Руководство по промптингу Anthropic, раздел про перенос промптов |
| Режь длинный документ на куски и скармливай по частям | Вставка длиннее 10 тысяч знаков сама становится файлом; окна выросли; на стороне API раннюю часть диалога сжимает сервер (бета, кнопки в чате нет) | Журнал ChatGPT от 25.03, 22.06 и 04.08.2026, документация Anthropic |
| Клади в контекст как можно больше | Окно выросло, но набивать его до отказа вредно: точность и полнота падают, эффект называют context rot | Документация Anthropic по контекстным окнам |
| Модель не знает ничего свежее даты обучения | Дата обучения на месте, но инструменты поиска включены по умолчанию; проверять надо наличие ссылок в ответе | Справка OpenAI про достоверность ответов |
| Покрути температуру, если ответ скучный | В журнале Gemini API параметры выборки помечены устаревшими 21.07.2026; в API OpenAI параметр на месте, поэтому универсальным советом это больше не работает | Журнал изменений Gemini API |
| Подсунь модели начало её собственного ответа | Приём отменён на новых моделях Anthropic, запрос с ним возвращает ошибку 400: возможности моделей выросли, и обходной манёвр перестал быть нужен | Руководство по промптингу Anthropic |
| Держи отдельный сервис под каждую задачу | Расшифровка речи, картинки, поиск и работа с файлами живут в одном диалоге | Журнал ChatGPT, записи 25.11.2025, 23.03.2026 и 07.08.2026 |
Что делать тем, кто учился по старым гайдам?
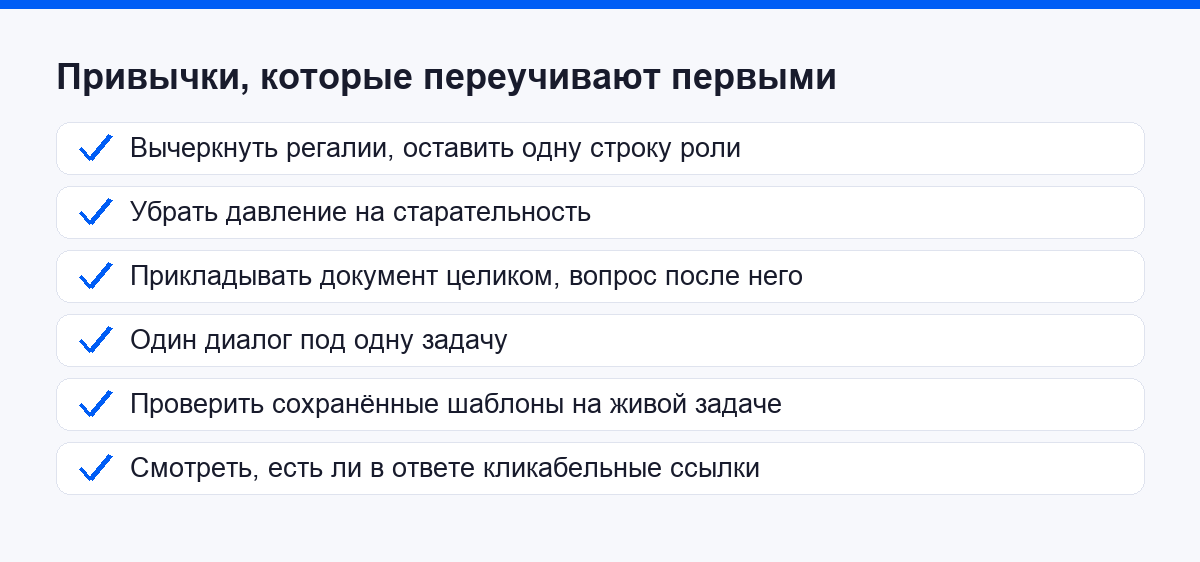
Ситуация на сегодня: переучивания требуют шесть привычек, остальное менять незачем. Убрать регалии из начала промпта, снять давление на старательность, перестать резать документы руками, навести порядок в контексте, пересобрать сохранённые шаблоны и проверять ссылки в ответах на свежие вопросы. По руководству по промптингу роли хватает одного предложения, проверено 3 сентября 2026 года.
Порядок переучивания стоит держать такой.
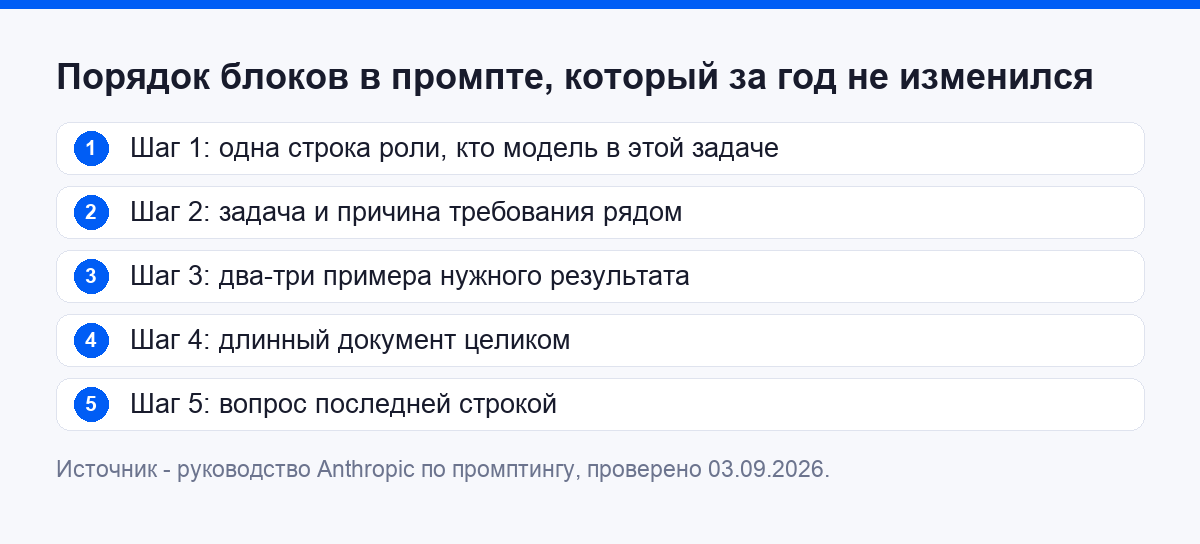
- Разберите свой самый частый промпт. Вычеркните регалии и оставьте одну строку роли: кто модель в этой задаче. Официальный пример роли в документации выглядит как «ты помощник по программированию, специализация Python», и этого хватает.
- Уберите давление на старательность. Формулировки вроде «проверь тщательно» разработчик просит убирать при переходе на новые модели: они срабатывают там, где не нужно, и модель начинает делать лишнюю работу.
- Прекратите нарезку. Прикладывайте документ файлом целиком и задавайте вопрос после него: порядок блоков внутри промпта разработчик измерял отдельно.
- Наведите порядок в контексте. Один диалог под одну задачу, лишние вложения удалять, длинную ветку начинать заново с коротким пересказом.
- Пересоберите сохранённые шаблоны. Всё, что лежит в заметках с позапрошлого сезона, проверьте на одной живой задаче и выбросьте то, что не улучшает результат.
- Проверяйте ссылки в ответах на свежие вопросы. Инструменты поиска включены по умолчанию, но ответ без единого кликабельного адреса на свежий вопрос сверяйте сами.
Пятый пункт закрывается набором. Держать шаблоны в одном месте и не копить мусор помогает личная библиотека промптов. Старых привычек ещё не завели? Начните с пошагового гайда для новичка, а сроки без прикрас собраны в разборе за сколько осваивают ChatGPT.
Работать с ChatGPT с нуля учат на онлайн-курсе «Работа с чат-GPT».
Пересобранные привычки полезно сразу назвать словами работодателя. Готовые формулировки для резюме подобраны в разборе навыка нейросетей в резюме.
Что осталось прежним в работе с нейросетями?
Ситуация на сегодня: базовые приёмы промптинга документация рекомендует ровно так же, как год назад. Ясная задача, причина требования, три-пять примеров нужного результата, длинный документ перед вопросом, разрешение сказать «не знаю» и проверка фактов человеком. По руководству по промптингу вопрос в конце промпта даёт в тестах до 30 процентов к качеству ответа, особенно на сложных задачах с несколькими документами. Проверено 3 сентября 2026 года.
Список того, что за год не сдвинулось, короткий. Именно поэтому он и полезен. Время на переучивание этих привычек тратить не надо. Пройдитесь по таблице со своим обычным промптом в руках и посмотрите, сколько строк у вас уже стоит.
| Что не изменилось | Почему это не меняется | Что сделать вам |
|---|---|---|
| Ясная и конкретная задача | Модель не знает контекста вашей работы и достраивает его сама | Формулируйте как для нового коллеги в первый день |
| Причина требования рядом с самим требованием | Без причины модель выбирает форму ответа наугад | Пишите «короткими абзацами, текст читают с телефона» |
| Три-пять примеров нужного результата | Готовый образец показывает нужную форму ответа без лишних объяснений | Держите пару готовых образцов рядом с промптом |
| Длинный документ выше вопроса | Порядок блоков внутри промпта разработчик измерял отдельно | Кладите договор первым, вопрос последней строкой |
| Разрешение сказать «не знаю» и требование цитат | Модель по умолчанию отвечает всегда, даже когда данных нет | Добавьте строку «если данных нет, так и скажи» |
| Проверка фактов человеком | Приёмы сокращают выдумки, но не убирают их полностью | Сверяйте цифры и цитаты по первоисточнику сами |
Возьмите договор на сорок страниц. Положите его в диалог целиком, одной строкой объясните, кто модель в этой задаче, и только последней строкой спросите, какие пункты про сроки оплаты выглядят рискованно. По руководству Anthropic по промптингу такой порядок блоков даёт в тестах до 30 процентов к качеству ответа на сложных задачах с несколькими документами. Страница проверена 3 сентября 2026 года, и за год эта рекомендация не поменялась ни словом.
Самая недооценённая строка в списке — «если данных нет, так и скажи». Руководство Anthropic по снижению выдумок прямо оговаривает, что такие приёмы сокращают количество выдумок, но не убирают их полностью, поэтому последняя проверка остаётся за вами. Механику самой выдумки разбирает статья про выдуманные факты.
Кто отвечает за результат и что нельзя вводить в чат?
Ситуация на сегодня: настройка «не обучаться на моих данных» существует и переключается за пару минут, но приватным диалог она не делает. По справке о работе с данными оценка ответа кнопкой может отправить всю переписку в обучение даже при выключенной настройке, а по справке о настройках данных временные чаты удаляются из систем через 30 дней. Обе страницы проверены 3 сентября 2026 года.
На личных тарифах OpenAI переписка используется для обучения, пока вы не отказались; отказ включается в настройках и переключается в любой момент. На бизнес-продуктах и в API обучения на данных нет по умолчанию. У Anthropic обучение на данных включается выбором пользователя, но переписка, отправленная вместе с оценкой ответа, хранится до пяти лет.
Отсюда правило, которое не зависит от настроек. Пароли, ключи доступа, чужие персональные данные и непубличные документы работодателя в чат не вводите. Они всё равно уходят на сервер и лежат в вашей истории диалогов.
Временный чат живёт 30 дней и потом стирается из систем разработчика. Разово спросить про чувствительное можно там, но пароли и чужие данные безопасными он всё равно не делает.
Вторая часть ответственности прописана в правилах использования OpenAI, действующих с 29 октября 2025 года. Там запрещена автоматизация решений с высокими ставками в чувствительных областях без проверки человеком, и перечень таких областей приведён прямо: найм, образование, жильё, финансы и кредит, страхование, юридическая и медицинская сферы, критическая инфраструктура, государственные услуги. Тот же документ говорит и про запрет консультаций, требующих лицензии, без участия лицензированного специалиста.
Читается это как скучная юридическая формальность, но смысл для новичка практический: обязанность проверить решение лежит на вас, и так написано в правилах самого разработчика. Список задач, которые лучше не отдавать чату вовсе, есть в материале что нельзя поручать ChatGPT.
Доступны ли зарубежные сервисы в России?
Ситуация на сегодня: у зарубежных разработчиков опубликованы списки поддерживаемых стран, и России в них нет. Это видно на страницах OpenAI, Anthropic и Google, все три открыты 3 сентября 2026 года. Подписка на такой сервис требует страны из списка поддерживаемых, а внутри страны официально работают свои сервисы с открытой документацией.
Ограничение идёт со стороны поставщика услуги, который сам определяет географию поддержки. Запрета пользоваться нейросетями тут нет.
Документация GigaChat описывает обработку данных, аналитические задачи, автоматизацию работы с текстом и распознавание изображений, а доступ оформляется через личный кабинет разработчика. Отдельные руководства там же посвящены истории чата, потоковой выдаче ответа, структурированным данным, файлам и вызову функций. Из этого списка новичку важно одно: диалог помнит историю, ответ печатается по мере готовности, файлы прикладывать можно. Страница нейросетей Яндекса описывает текстовую и визуально-языковую модели и поиск, который объединяет возможности Поиска и YandexGPT, и говорит, что модели доступны внешним разработчикам в Yandex Cloud.
Сравнить российские сервисы с зарубежными по цифрам в этой статье не получится: конкретных чисел (размер контекста, лимиты, бесплатные квоты) на их обзорных страницах нет. Если цифры вам нужны, снимайте их в документации самого сервиса. Чем пользуются изнутри страны, перечисляет обзор доступных в России нейросетей.
Навык не привязан к одному сервису. Постановка задачи, работа с контекстом, проверка ответа переносятся между любыми моделями, потому что термины и приёмы в документации трёх разных разработчиков совпадают. Переучиваться при переезде вам придётся только на уровне кнопок и названий.
Как не отстать в следующий раз?
Ситуация на сегодня: у каждого крупного разработчика есть датированный журнал обновлений, и он ничего не пересказывает. У ChatGPT такая страница лежит в справке, у Claude в поддержке, у Gemini API работает отдельный changelog: там, например, 21 июля 2026 года параметры выборки помечены устаревшими. Полчаса раз в месяц закрывают вопрос «что успело поменяться».
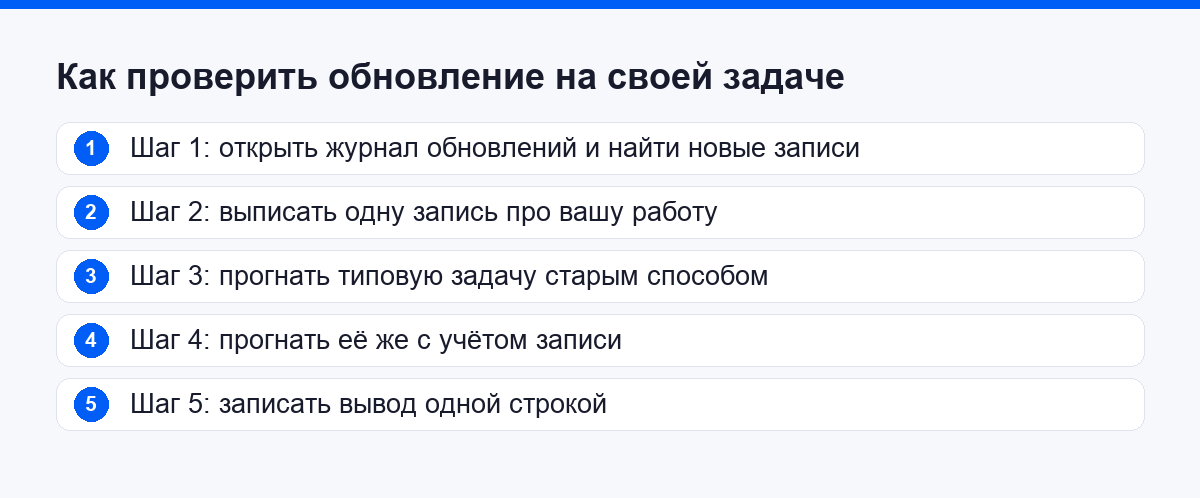
Проверка занимает полчаса и делается по одному и тому же кругу.
- Откройте журнал обновлений своего сервиса и пролистайте записи с прошлой проверки. Каждая запись датирована, поэтому видно, что появилось после вашего последнего захода.
- Выпишите одну запись, которая касается вашей работы. Не всё подряд: изменения генерации видео бухгалтеру не пригодятся.
- Прогоните свою типовую задачу дважды. Один раз старым способом, один раз с учётом записи.
- Сравните результат и решите. Стало лучше по времени или качеству, привычка меняется; разницы нет, живёте как жили.
- Запишите вывод одной строкой. Через месяц вы не вспомните, что уже проверяли.
Возьмите готовую задачу для такой проверки из подборки двадцати сценариев для новичка.
Формулировки прессы обычно шире того, что написал разработчик, поэтому первоисточником считается журнал обновлений или справка, а пересказ им быть не может. Если утверждение не находится на официальной странице с датой, в рабочие привычки оно не переносится.
Сколько стоит начать и какие ошибки делают чаще всего?
Ситуация на сегодня: вход в тему по-прежнему бесплатный. Журнал обновлений отмечает безлимитные текстовые чаты и кнопку рассуждения на бесплатных тарифах записями от 6 и 14 августа 2026 года, а проекты с загрузкой файлов открылись на бесплатном тарифе ещё 3 сентября 2025 года. Журнал обновлений, проверено 3 сентября 2026 года.
Платят за скорость, объём и глубину рассуждения. Сама возможность учиться в деньги не упирается. Стоит ли вам платить прямо сейчас, считает статья про бесплатный и платный ChatGPT.
Ошибки, которые встречаются чаще прочих, собираются в короткий список.
- Копировать промпт из старого гайда и не проверять его на своей задаче. Часть таких шаблонов сегодня добавляет шума, часть перестала работать, и отличить одно от другого можно только на своей задаче.
- Верить дате обучения и не смотреть на ссылки. Ответ без единого кликабельного адреса на свежий вопрос проверяйте сами.
- Включать глубокое рассуждение на всё подряд. Оно занимает контекстное окно и оплачивается как вывод, а на простой правке текста ничего не добавляет.
- Складывать в один диалог месяц работы. Точность падает по мере роста числа токенов, поэтому заводите новую ветку под новую задачу.
- Вводить чужие персональные данные и закрытые документы. Настройка обучения этого не отменяет, проверьте её до того, как вставите документ.
- Гнаться за именем версии вместо задачи. Выбор давно свёлся к уровню рассуждения, и подбирать под работу стоит именно его.
Полгода ежедневной работы с нейросетями, а показать работодателю нечего: примеры не сохранены, «до и после» не зафиксировано. Собирать такие примеры по ходу работы учит разбор портфолио работ с нейросетями.
Вопросы про перемены в работе с нейросетями
Устарели ли длинные промпты из старых шаблонов?
Устарела их раздутая часть. Руководство по промптингу говорит, что роль в системной инструкции работает и одного предложения достаточно, а официальный пример роли занимает одну строку. Многоэтажные регалии в документации не встречаются вовсе. Задача, требования и причина этих требований остаются полезными, а вот регалии про эксперта мирового уровня можно вычеркнуть без потерь.
Нужно ли резать длинный документ на части?
Резать вручную стоит ровно в одном случае — когда документ не помещается в окно вашего сервиса. В массовом сценарии этим занимается сам чат: крупная вставка автоматически становится приложенным файлом, и записи об этом в журнале обновлений датированы 25 марта, 22 июня и 4 августа 2026 года. На стороне API раннюю часть длинного диалога сжимает сервер, но это бета и кнопки в чате для неё нет.
Всегда ли стоит включать рассуждающий режим?
Нет, и цена вопроса тут прямая: за глубину вы платите временем и деньгами. Включайте её там, где нужна цепочка шагов: расчёт, разбор договора, план, поиск ошибки в таблице. На задачах вроде «сократи абзац» или «поправь стиль» глубокий режим забирает ресурс и результат не меняет.
Знает ли нейросеть сегодняшние новости?
Смотрите на ссылки в самом ответе. Есть адреса, по которым можно перейти и убедиться, — модель ходила в интернет; ссылок нет, ответ построен на данных обучения. По справке OpenAI инструменты поиска включены по умолчанию для всех моделей, но проверять стоит каждый конкретный ответ.
Придётся ли переучиваться при смене сервиса?
Основное переносится. Постановка задачи, работа с контекстом, примеры результата и проверка ответа устроены одинаково у разных разработчиков, и термины в их документации совпадают. Меняются интерфейс, названия кнопок и набор доступных инструментов. Именно поэтому навык стоит описывать через задачи, которые вы решаете, а не через название конкретного чата.
Источники
- Журнал обновлений ChatGPT — датированные записи про контекстное окно, автоприкрепление вставок, библиотеку файлов, уровни рассуждения, голос и пользовательские инструкции. Проверено 03.09.2026.
- Справка OpenAI о достоверности ответов — инструменты поиска включены для всех моделей по умолчанию, ограничения модели, рекомендация проверять важное. Проверено 03.09.2026.
- Документация Anthropic про контекстные окна — состав окна, эффект context rot, серверное сжатие истории, размеры окон и лимит вложений. Проверено 03.09.2026.
- Руководство Anthropic по промптингу — роль одним предложением, отказ от давления на старательность, отмена подстановки начала ответа, длинный документ выше вопроса. Проверено 03.09.2026.
- Руководство Anthropic по снижению выдумок — приёмы сокращают количество выдумок, но не убирают их полностью. Проверено 03.09.2026.
- Журнал обновлений Claude — память из истории чатов и переход к отдельным записям. Проверено 03.09.2026.
- Журнал изменений Gemini API — пометка параметров выборки устаревшими от 21.07.2026. Проверено 03.09.2026.
- Руководство OpenAI по рассуждающим моделям — токены рассуждения занимают контекстное окно и считаются как вывод. Проверено 03.09.2026.
- Справка OpenAI об использовании данных — обучение на переписке, отказ от него, оценка ответа, отсутствие обучения на бизнес-продуктах и в API. Проверено 03.09.2026.
- Справка OpenAI о настройках данных — где выключается обучение и срок жизни временного чата. Проверено 03.09.2026.
- Политика Anthropic об обучении на данных — обучение по выбору пользователя, срок хранения переписки с оценкой. Проверено 03.09.2026.
- Правила использования OpenAI — запрет автоматизации решений с высокими ставками без проверки человеком, перечень чувствительных областей. Проверено 03.09.2026.
- Список поддерживаемых стран OpenAI — официальная география доступа. Проверено 03.09.2026.
- Список поддерживаемых стран Anthropic — официальная география доступа. Проверено 03.09.2026.
- Доступные регионы Gemini API — официальная география доступа. Проверено 03.09.2026.
- Обзор возможностей GigaChat — задачи, руководства по работе с моделями и порядок доступа. Проверено 03.09.2026.
- Страница нейросетей Яндекса — текстовая и визуально-языковая модели, поиск, доступ разработчикам через Yandex Cloud. Проверено 03.09.2026.

