


Содержание статьи
- Какие термины нужны в первый день работы с нейросетями?
- Что такое промпт и чем он отличается от вопроса?
- Что такое контекст и контекстное окно?
- Зачем задавать роль и системную инструкцию?
- Токен, температура и галлюцинация: что за ними стоит?
- Что меняют мультимодальность и рассуждающий режим на практике?
- Где вы работаете сейчас, в чате или из программы?
- Что каждое понятие меняет в промпте?
- Как переписать один свой рабочий запрос?
- Как разбить задачу на два шага и увидеть промежуточный результат?
- Где основы работы с нейросетями перестают помогать?
- Что читать дальше после основ работы с нейросетями
- Короткие ответы по терминам нейросетей
- Источники
Основы работы с нейросетями укладываются в девять понятий: промпт, контекст и контекстное окно, роль и системная инструкция, токен, галлюцинация, мультимодальность, рассуждающий режим, температура, обращение к модели из программы. Остальной словарь дописывается по ходу и на старте не нужен. Термин здесь работает рычагом и отвечает на вопрос «что поменять в запросе, когда ответ вышел слабым». Работает такой подход не везде. Там, где вы не можете проверить ответ, никакой словарь не спасёт, и это честная граница метода.
Дальше по порядку. Сначала минимум теории с бытовым примером к каждому термину и таблица «понятие / что делает на практике / что менять в промпте». Потом два практических захода руками — переписать один свой рабочий запрос и разбить задачу на два шага. В конце раздел про то, где теория заканчивается, и подборка соседних разборов блога.
Какие термины нужны в первый день работы с нейросетями?
В двух словах: в первый день хватает трёх понятий. Промпт, контекст и роль закрывают почти все ситуации первых дней. Ещё три термина (токен, галлюцинация, мультимодальность) понадобятся на первой неделе, когда упрётесь в лимиты и увидите первое уверенное враньё. Температура и обращение к модели из программы ждут второго месяца, потому что в обычном чате вы ими не управляете вовсе.
Словари терминов обычно устроены по алфавиту, и для первых дней это худший порядок. Понятия нужны не одновременно, и половина списка не пригодится вам ещё месяц.
Рабочий порядок другой. Тройкой «промпт, контекст, роль» чинится большинство слабых ответов, поэтому она идёт первой. Токен, галлюцинация и мультимодальность объясняют следом, почему длинный диалог начинает путаться, откуда берутся выдуманные ссылки и во что обходятся скриншоты. Последними идут температура и обращение к модели из программы, потому что в чате их просто нет.
Пошаговый вход в интерфейс у нас разобран отдельно, в гайде по первым шагам без опыта. Тот текст отвечает, куда нажать и что открыть; здесь речь про язык, которым вы объясняете себе причину именно такого ответа. Сколько времени уходит на каждый этап, показывает соседний разбор за сколько осваивают ChatGPT.
Что такое промпт и чем он отличается от вопроса?
В двух словах: промптом называют задание модели, а вопрос к ней составляет лишь часть задания. Документация OpenAI описывает составление промпта как способ «программировать» модель инструкциями и примерами (developers.openai.com, проверено 03.09.2026). Anthropic советует давать в промпте от трёх до пяти примеров нужного ответа и объяснять причину требования, потому что с названной причиной модель точнее попадает в цель.
Ближайшая бытовая аналогия — просьба к живому человеку. «Купи молока» и «купи литр молока 2,5% в пакете, если такого нет, возьми 3,2%, безлактозное не бери» дают разный результат при одном и том же исполнителе. Второе поручение содержит контекст, формат и запасной вариант.
С моделью работает та же логика. Официальная рекомендация Anthropic предлагает думать о модели как о толковом новом сотруднике, который не знает ваших порядков и договорённостей (platform.claude.com, проверено 03.09.2026).
Оттуда же золотое правило проверки. Покажите свой промпт коллеге, у которого нет контекста задачи, и попросите выполнить. Растеряется коллега, растеряется и модель.
Как выглядит тот же запрос после правки? Один промпт до и после разобран в материале как переписать промпт от нужного результата. Здесь же мы собираем детали, из которых промпт складывается.
Что такое контекст и контекстное окно?
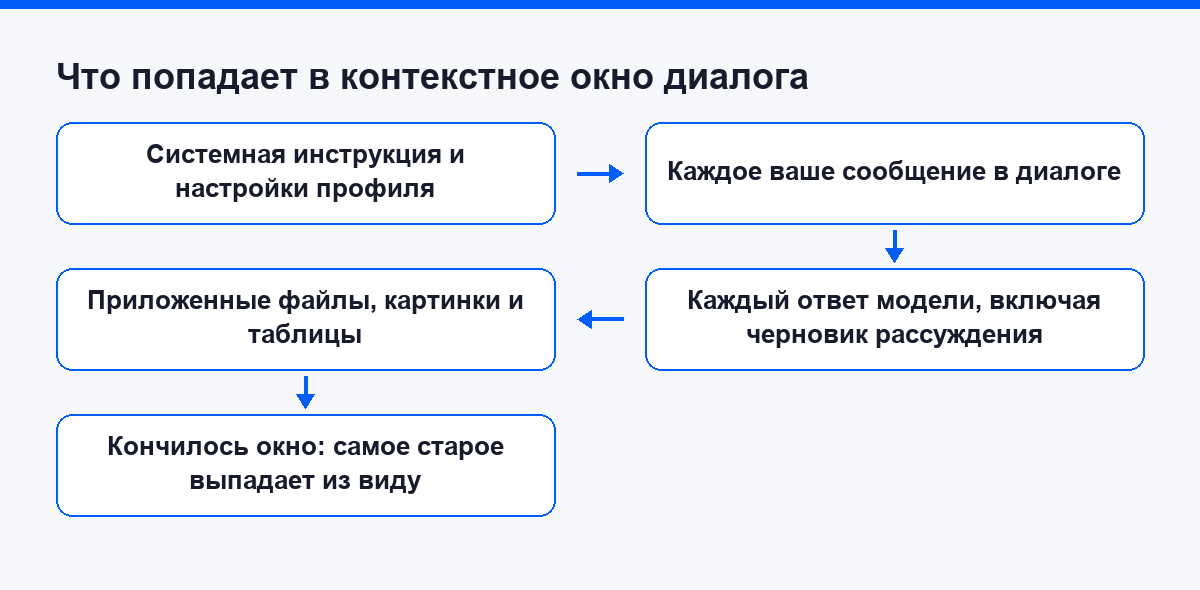
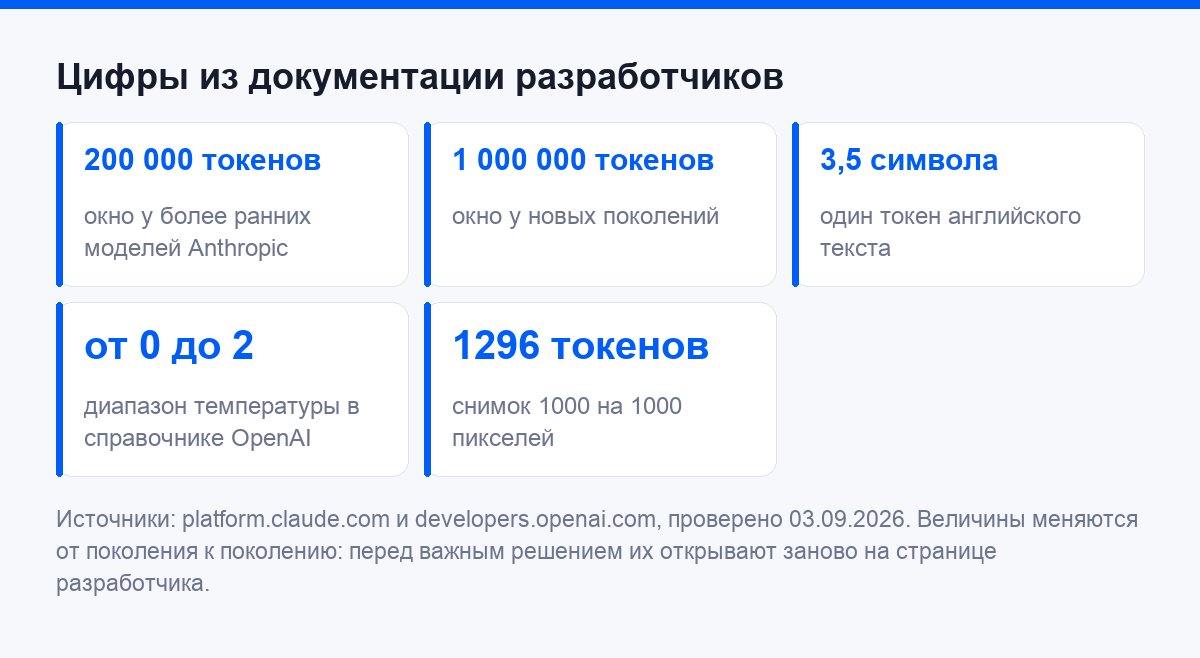
В двух словах: контекстное окно работает как рабочая память диалога. Внутрь попадает всё — системная инструкция, каждое ваше сообщение, ответы модели, приложенные файлы и картинки. У более ранних моделей Anthropic окно вмещает 200 000 токенов, у новых поколений 1 000 000 (platform.claude.com, проверено 03.09.2026). Величина меняется от поколения к поколению, поэтому перед важным решением её проверяют на странице разработчика.
Бытовой пример: рабочий стол. Пока места хватает, все бумаги перед глазами. Место кончилось, и самое старое уезжает на пол, хотя вы про него не забыли.
Миллион токенов в бытовых мерах документация Google описывает так: 50 000 строк кода при стандартных 80 знаках в строке, восемь англоязычных романов средней длины, расшифровки более чем двухсот выпусков подкаста (ai.google.dev, проверено 03.09.2026). Слово «англоязычных» здесь не случайно. Русский текст режется на токены мельче английского, поэтому наших романов в то же окно уместится меньше.
Главное про окно написано прямым текстом, а узнаёте вы об этом обычно последним. Больше контекста не значит лучше. По мере роста числа токенов точность и полнота ответов падают, и в документации это названо деградацией контекста (context rot). Отбор того, что лежит в контексте, важен не меньше объёма окна.
Зачем задавать роль и системную инструкцию?
В двух словах: системная инструкция задаёт правила на весь диалог и стоит выше отдельного сообщения. В справочнике OpenAI роль system описана как инструкции разработчика, которым модель следует независимо от того, что пишет пользователь (developers.openai.com, проверено 03.09.2026). Anthropic добавляет, что разницу даёт даже одно предложение роли (platform.claude.com, проверено 03.09.2026).
Дома это выглядело бы так. «Обувь снимаем в прихожей» действует всегда, «подай, пожалуйста, соль» относится к одному моменту.
В обычном чате роль системной инструкции играют настраиваемые инструкции профиля и инструкции проекта. Всё, что вы туда запишете, действует на каждый новый диалог, и переспрашивать об этом не придётся.
Многоэтажные «магические» роли на десять абзацев в документации не встречаются вовсе. Пример системной инструкции у Anthropic занимает одну строку — помощник по коду, специализация Python. Этого достаточно, чтобы сместить тон и способ рассуждения.
Токен, температура и галлюцинация: что за ними стоит?
В двух словах: токеном называют кусок текста, на которые модель режет ваш запрос и свой ответ. По оценке Anthropic один токен отвечает примерно 3,5 символам английского текста, и точное число зависит от языка (platform.claude.com, проверено 03.09.2026). Температура правит разбросом ответов и в справочнике OpenAI идёт от 0 до 2: около 0,8 ответы разнообразнее, около 0,2 повторяются чаще (developers.openai.com, проверено 03.09.2026). Галлюцинацией называют уверенный ответ, который расходится с фактами или с тем, что модели дали.
Токен не совпадает ни с буквой, ни со словом. Считайте его счётчиком такси, который тикает и на ваш вопрос, и на ответ модели.
На кириллице текст режется мельче, чем на английском, но официальной цифры для русского языка разработчики не публикуют, поэтому точное соотношение никто честно назвать не может. Практический вывод от этого не меняется. В токенах считается и ваш вопрос, и ответ модели, и приложенный файл, и в них же меряются все лимиты.
Числа лимитов разработчики меняют вместе с поколениями моделей, поэтому дата проверки стоит у каждой цифры в статье. Перед важным решением такую цифру открывают заново на странице разработчика.
Температура живёт в настройках обращения к модели из программы, а в обычном чате ручки для неё на экране нет. Представьте повара с рецептом, который у нижней границы готовит строго по написанному, а у верхней начинает импровизировать. Обещать «поставьте ноль и получите тот же ответ» тоже нельзя. Глоссарий Anthropic прямо предупреждает, что даже при нуле одинаковые запросы дают разные ответы.
Под галлюцинацию у Anthropic попадает текст, который фактически неверен или расходится с тем, что модели дали; формулировка взята из руководства по снижению галлюцинаций (platform.claude.com, проверено 03.09.2026). В быту так ведёт себя уверенный собеседник, который называет несуществующий номер закона тем же тоном, что и настоящий. Для модели такое поведение штатно, сервис при этом работает исправно.
Опаснее всего здесь выдуманная ссылка на источник. Она выглядит как подтверждение и снимает желание проверять. Почему модель придумывает страницу, которой нет, объясняет статья почему нейросеть выдумывает факты. Дальше нас интересует практическая часть, то есть что с этим делать в промпте.
Базовых приёмов в руководстве три:
- Разрешить модели сказать «не знаю» прямым текстом в промпте.
- На длинных документах (в руководстве это документы длиннее двадцати тысяч токенов) сначала просить выписать дословные цитаты и лишь потом делать работу.
- Требовать ссылку или цитату под каждым утверждением.
Разработчик тут же честно оговаривает: приёмы сильно снижают галлюцинации, но не устраняют их полностью, поэтому критичное проверяют всегда.
Что меняют мультимодальность и рассуждающий режим на практике?
В двух словах: мультимодальность означает, что на вход идёт не только текст. Картинка тоже стоит токенов и тоже занимает окно: Anthropic режет изображение на квадраты 28×28 пикселей, и снимок 1000×1000 обходится в 1296 визуальных токенов (platform.claude.com, проверено 03.09.2026). Десяток скриншотов съедает контекстное окно быстрее страницы текста. Рассуждающий режим добавляет к ответу невидимый черновик, который тоже занимает окно.
Разница с обычным текстом примерно как между письмом и посылкой с фотографиями — адрес тот же, а места и веса нужно заметно больше.
Лимиты на картинки Anthropic публикует там же: 20 изображений на сообщение в чате, до 600 на запрос из программы и 100 на запрос у моделей с окном 200 000 токенов (platform.claude.com, проверено 03.09.2026). У других сервисов лимиты свои. Форматы стандартные, анимация не поддерживается, из GIF берётся только первый кадр.
Границы зрения модели описаны на той же странице, и держать их в голове полезно. Мелкие снимки (меньше 200 пикселей), повёрнутые и низкого качества модель разбирает с ошибками. Пересчёт объектов на картинке приблизительный. Определить, сгенерировано изображение нейросетью или снято, модель не берётся, и полагаться на её вердикт тут нельзя.
Скриншот обходится дороже страницы текста, поэтому в длинном рабочем диалоге первыми режут именно картинки, а от экрана оставляют нужный кусок.
Рассуждающий режим устроен иначе. До ответа модель пишет черновик для себя, как школьник, который считает на полях, прежде чем записать ответ в чистовик. По документации OpenAI такие токены не видны при обращении из программы, но занимают место в контекстном окне и оплачиваются как обычный ответ модели (developers.openai.com, проверено 03.09.2026). Anthropic описывает то же самое со своей стороны, и токены размышления входят в лимит окна наравне с остальными.
Отсюда простое правило включения. Режим окупается на многошаговом (разбор договора, расчёт, план работ) и впустую тратит окно и деньги на просьбе сократить абзац или подобрать заголовок.
Где вы работаете сейчас, в чате или из программы?
В двух словах: чат и обращение из программы ведут к одной и той же модели, только через разные двери. Разница видна по лимитам: у Anthropic в чате идёт 20 изображений на сообщение, из программы до 600 на запрос (platform.claude.com, проверено 03.09.2026). В чате модель, инструменты и настройки выбраны за вас, из программы вы задаёте их сами и платите за токены.
| Что сравниваем | Чат | Обращение из программы |
|---|---|---|
| Кто задаёт системную инструкцию | вы, через настройки профиля и проекта | вы, отдельным полем в каждом запросе |
| Температура | недоступна в большинстве чатов | задаётся числом от 0 до 2 |
| История диалога | ведёт сервис | собираете и отправляете сами |
| Оплата | подписка на сервис | по количеству токенов |
| Кому нужно на старте | всем новичкам | тем, у кого задача повторяется сотни раз |
Проще всего представить кафе и собственную кухню. В кафе всё закуплено, приготовлено и посчитано за вас, на своей кухне вы выбираете продукты сами и платите за каждый.
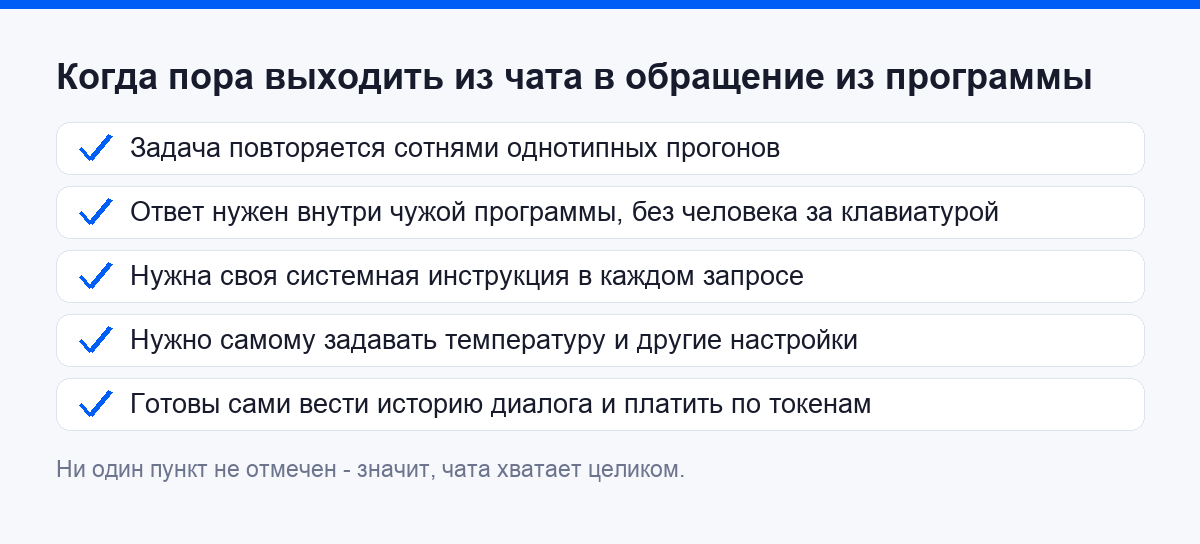
Второй путь нужен в двух случаях. Задача повторяется сотнями однотипных прогонов или должна работать внутри чужой программы без человека за клавиатурой. Во всех остальных случаях чат закрывает потребность целиком.
На старте не нужно ничего, кроме аккаунта. Словарь из этой статьи ничего не стоит и проверяется в любом чате. Платный доступ и обращение к модели из программы становятся нужны только тогда, когда упрётесь в лимиты; что меняет оплата, показывает сравнение бесплатного и платного доступа.
Что каждое понятие меняет в промпте?
В двух словах: все девять понятий помещаются в одну таблицу «понятие / что делает на практике / что менять в промпте». Смотреть её удобнее с последней графы: сначала «что менять в промпте», потом название термина. Так словарь превращается в набор рычагов, и ответ на вопрос «почему вышло плохо» находится за несколько секунд, без перечитывания всей статьи.
| Понятие | Что делает на практике | Что менять в промпте |
|---|---|---|
| Промпт | задаёт модели задание целиком | добавить контекст, формат ответа и пример |
| Контекст и контекстное окно | рабочая память диалога и её предел | убрать лишнее, разбить длинный текст, начать новый диалог |
| Роль и системная инструкция | угол зрения и правила на весь диалог | одна строка о том, кем выступает модель |
| Токен | единица счёта запроса, ответа и лимитов | сократить приложенное, не сокращать задание |
| Галлюцинация | уверенный ответ без опоры на факты | разрешить «не знаю», требовать цитаты |
| Мультимодальность | вход не только текстом | слать меньше скриншотов, обрезать нужное |
| Рассуждающий режим | черновик модели до ответа | включать на многошаговое, гасить на мелкое |
| Температура | разброс ответов от повторяемого до неожиданного | в чате не трогать, из программы задать числом |
| Обращение к модели из программы | тот же ответ без чата, оплата по токенам | выносить туда то, что повторяется сотнями прогонов |
Чаще прочих путают дообучение и промпт-инжиниринг, то есть работу над самим текстом запроса. Дообучение по глоссарию Anthropic означает дальнейшее обучение готовой модели на дополнительных данных, и в чате его не сделать. Всё, что делает практик первый год, живёт целиком внутри промпта.
Как переписать один свой рабочий запрос?
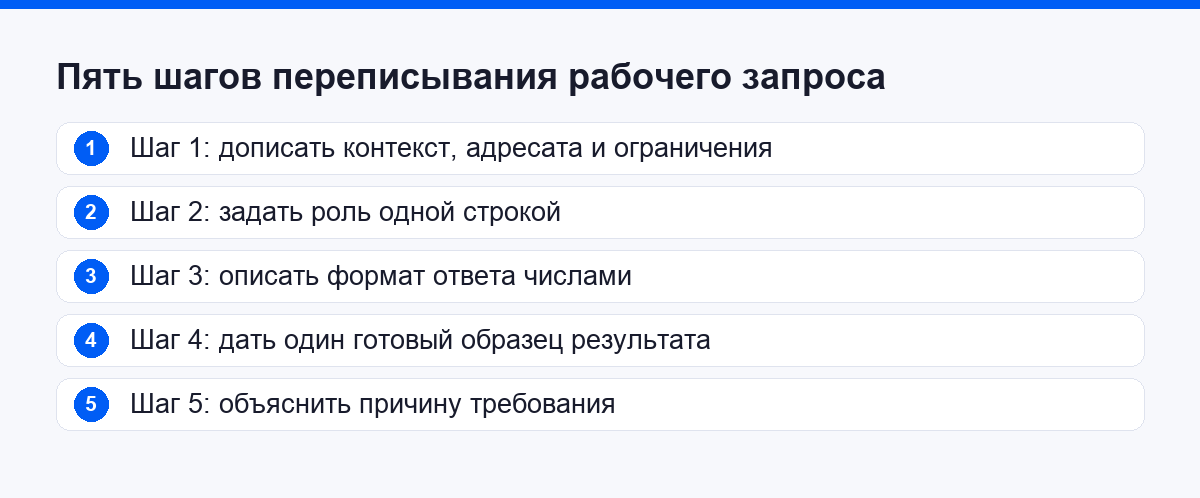
В двух словах: первый заход делается на живом материале. Берёте запрос, который недавно дал слабый ответ, и дописываете пять вещей: контекст, роль, формат ответа, пример и причину требования. Проверку качества даёт руководство Anthropic. Промпт, который ставит в тупик коллегу без контекста задачи, поставит в тупик и модель (platform.claude.com, проверено 03.09.2026).
Возьмите свой недавний запрос из истории. Подойдёт любой, где ответ пришлось переделывать руками: письмо клиенту, описание товара, план встречи.
- Допишите контекст. Кто адресат, что он уже знает, чем закончился прошлый разговор, какое ограничение действует. Три строки контекста меняют ответ сильнее, чем десять правок формулировки.
- Задайте роль одной строкой. «Ты редактор деловой переписки» или «ты кладовщик со стажем». Длиннее одной строки не нужно: документация говорит о заметном эффекте уже от одного предложения.
- Опишите формат ответа. Сколько абзацев, есть ли список, нужен ли заголовок, какая длина. Формат задаётся числами, а не словами «покороче».
- Дайте пример. Один готовый образец нужного результата работает лучше абзаца объяснений. Anthropic рекомендует от трёх до пяти примеров, но и с одного разница видна сразу.
- Объясните причину требования. «Текст прочитают вслух на планёрке, поэтому без сокращений и скобок» работает надёжнее сухого запрета.
Отправьте старый и новый запрос в двух соседних диалогах и сравните ответы. Отличие видно на глаз и сразу показывает, какой из пяти кусков дал основной прирост.
Как разбить задачу на два шага и увидеть промежуточный результат?
В двух словах: второй заход сложнее первого. Задача делится надвое, и модель показывает промежуточный результат до финального ответа. Приём взят из официального руководства Anthropic: на документах длиннее двадцати тысяч токенов сначала просят выписать дословные цитаты и только потом делать работу (platform.claude.com, проверено 03.09.2026).
Запрос в один заход «прочитай пять отзывов и напиши, что чинить» проверить нечем. Ответ приходит готовым выводом, и вы не видите, откуда он взялся.
Разбейте задачу так:
- Шаг первый, только выписки. «Выпиши из пяти отзывов дословные фразы про доставку. Ничего не обобщай. Если фразы нет, напиши, что её нет».
- Проверка глазами. Сверьте выписки с исходными отзывами. На этом шаге ловится и выдуманная цитата, и пропущенный отзыв.
- Шаг второй, вывод по выпискам. «Опираясь только на выписки выше, назови три проблемы доставки и отметь, сколько отзывов подтверждает каждую».
- Запрет на посторонние знания. Добавьте строку «не используй ничего, кроме приведённых цитат». Официальное руководство называет этот приём ограничением внешних знаний.
Промежуточный шаг стоит лишней минуты и одного сообщения в окне, зато ошибка ловится там, где её ещё можно исправить. Тот же приём лежит в основе проверки ответов нейросети по источникам и цифрам.
Где основы работы с нейросетями перестают помогать?
В двух словах: словарь бесполезен там, где вы не можете проверить ответ. Anthropic честно пишет, что приёмы против галлюцинаций их сильно снижают, но не устраняют полностью, и критичное надо проверять всегда (platform.claude.com, проверено 03.09.2026). Задачу без способа проверки не отдают модели ни при каком промпте.
Первая ситуация возникает, когда результат нечем проверить. Модель ответит уверенно на любой вопрос, и уверенность тона ничего не говорит о правильности. Промпт тут не спасёт.
Вторая — высокая цена ошибки: деньги, здоровье, юридические последствия, отношения с клиентом. Здесь ответ модели годится как черновик, а решение остаётся за человеком.
Третья касается данных, которые нельзя выносить наружу. Персональные сведения, непубличные документы работодателя, пароли и ключи в чат не вводят независимо от настроек приватности. Что именно туда не отправляют, перечислено в материале про безопасность рабочих данных.
Есть и четвёртая, менее очевидная. Ценность задачи бывает именно в вашем личном опыте, и тогда модель подменит его усреднением. Список задач, которые ей вообще не стоит отдавать, собран в статье что нельзя поручать ChatGPT.
Что читать дальше после основ работы с нейросетями
В двух словах: девять понятий закрывают язык, дальше начинается практика. Соседние разборы блога делят её по задачам: какие рабочие задачи меняются первыми, как описать навык в резюме, что спрашивают о нейросетях на собеседовании, что показать в портфолио. Вместе они складываются в маршрут на первые месяцы работы.
Систематически весь этот язык разбирают на онлайн-курсе «Работа с чат-GPT».
Следующий шаг зависит от того, зачем вам этот язык:
- Какие рабочие задачи меняются первыми, если подключить модель к обычной неделе.
- Как назвать этот навык в резюме, разобрано в заметке навык нейросетей в резюме.
- Что спрашивают про нейросети на собеседовании и какие ответы звучат убедительно.
- Портфолио работы с нейросетями: из чего его собрать, когда проектов ещё нет.
Короткие ответы по терминам нейросетей
Сколько символов русского текста в одном токене?
На сентябрь 2026 официальной цифры для русского языка ни один из трёх разработчиков не публикует. Anthropic даёт оценку только для английского, около 3,5 символа на токен, и сразу оговаривает зависимость от языка. Практический обход простой: смотреть счётчик самого сервиса и закладывать запас. Точной цифре для русского токена из чужих статей верить не стоит, подтвердить её нечем.
Нужно ли новичку разбираться в температуре?
В первый месяц нет. Слабый ответ в чате чинится текстом запроса, потому что ручки для температуры на экране там нет. Термин пригодится на переходе к обращению из программы, где значение задаётся числом от 0 до 2 и напрямую влияет на разброс ответов.
Чем дообучение отличается от промпт-инжиниринга?
Промпт-инжиниринг меняет только текст запроса, и сама модель после него остаётся прежней. Дообучение меняет модель, и для него нужны свои размеченные данные, отдельный прогон и бюджет, которого у одного человека обычно нет. Поэтому первый год практик работает запросом, и этого хватает почти на все рабочие задачи.
Почему длинный диалог начинает путаться?
Кончается контекстное окно. Признаки заметные: модель забывает договорённости из начала переписки, повторяет уже сказанное и путает цифры. Лечится новым диалогом, куда вы переносите короткий пересказ сути и нужные файлы, а старую переписку за собой не тянете.
Можно ли просить модель проверить, сделана ли картинка нейросетью?
Нет. Документация Anthropic говорит прямо: модель не определяет происхождение изображения и может ошибиться, если её об этом спросить. Такой вердикт ничего не доказывает ни в работе, ни в споре, и проверять происхождение картинки приходится другими средствами.
Источники
- Глоссарий Anthropic: токен, температура, контекстное окно, дообучение (проверено 03.09.2026)
- Anthropic: контекстное окно и что в него входит (проверено 03.09.2026)
- Anthropic: принципы составления промпта (проверено 03.09.2026)
- Anthropic: как снижать галлюцинации (проверено 03.09.2026)
- Anthropic: работа с изображениями, лимиты и ограничения (проверено 03.09.2026)
- OpenAI: базовые понятия, токены и промпт (проверено 03.09.2026)
- OpenAI: справочник Chat Completions, роли system и developer (проверено 03.09.2026)
- OpenAI: параметр температуры в справочнике Responses (проверено 03.09.2026)
- OpenAI: рассуждающие модели и токены размышления (проверено 03.09.2026)
- Google: длинный контекст и миллион токенов в бытовых мерах (проверено 03.09.2026)

