


Содержание статьи
- Какое задание про нейросети дают на собеседовании?
- Как к такому заданию подходят на первом заходе?
- Что идёт не так на первом заходе?
- Как переделать работу за пять шагов
- Что получилось со второго захода?
- Было и стало: чем отличаются два захода
- Что переносится на ваши рабочие задачи
- Какие вопросы про нейросети задают вокруг задания?
- Где вы не станете применять нейросеть?
- Как вы проверяете факты в ответе?
- Что делать с конфиденциальными данными?
- Сколько времени экономит нейросеть и на чём?
- Какие ошибки в таком разговоре стоят дороже всего?
- Что ещё спрашивают на собеседовании про ИИ
- Источники
Вопросы про нейросети на собеседовании редко звучат как экзамен по теории. Чаще дают задание — вот сырые данные, покажите, как вы решите это с помощью нейросети. Дальше разговор идёт вокруг того, что вы сделали руками.
Спрашивают про границы — где вы моделью пользоваться не станете, как проверяли числа, что не отправите в чужой сервис. Готового публичного свода таких вопросов не существует, поэтому темы ниже выведены из требований живых вакансий и официальных ограничений разработчиков моделей. Ниже один случай целиком, вместе с честным провалом на первом заходе. Случай собирательный. Он сложен из повторяющихся требований к навыку и типовых ошибок первого захода, конкретного собеседования за ним нет.
Разбор идёт сквозным маршрутом по одной задаче. Сначала формулировка задания, потом первый заход и его провал, потом пять шагов, которые чинят результат, таблица «было и стало», а следом типичные темы разговора вокруг сданной работы и ответы, которые опираются на документы вместо общих слов.
Какое задание про нейросети дают на собеседовании?
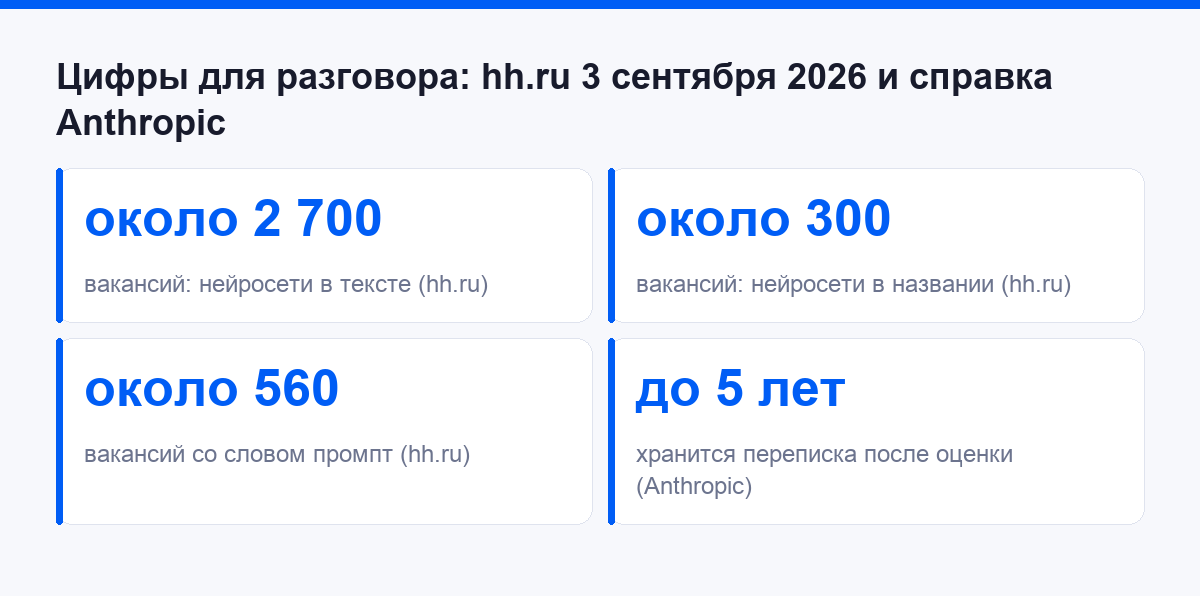
Коротко: вместо теории дают короткое тестовое. На входе сырьё из разных мест — выгрузка, переписка, пара файлов. Просят свести данные в таблицу и сделать по ней короткую сводку для руководителя. Навык требуют уже не только на профильных ролях: на замере 3 сентября 2026 слово «нейросети» стояло в тексте около 2 700 вакансий hh.ru, а в названии таких вакансий около 300.
Числа держатся ровно один день. Площадка пересчитывает выдачу постоянно, поэтому по ссылке у вас будут свои цифры, а точность до единицы здесь ложная. Значение имеет разрыв в девять раз, и он объясняет весь жанр задания. Нейросети чаще идут строкой в требованиях к обычной должности, чем становятся отдельной работой: их упоминают вакансии офис-менеджера, ассистента, копирайтера, дизайнера, маркетолога, менеджера маркетплейсов, юриста и преподавателя.
Счётчик меряет спрос на навык. О том, как идёт сам разговор, он не говорит ничего. Вывод из него один. Работодатель ждёт умения на рядовой должности и проверит его тем способом, который у него есть.
Отсюда и форма проверки. Проверяют одно — испортите ли вы рабочий процесс, если пустить вас к реальным данным. Определение температуры модели на этот вопрос не отвечает.
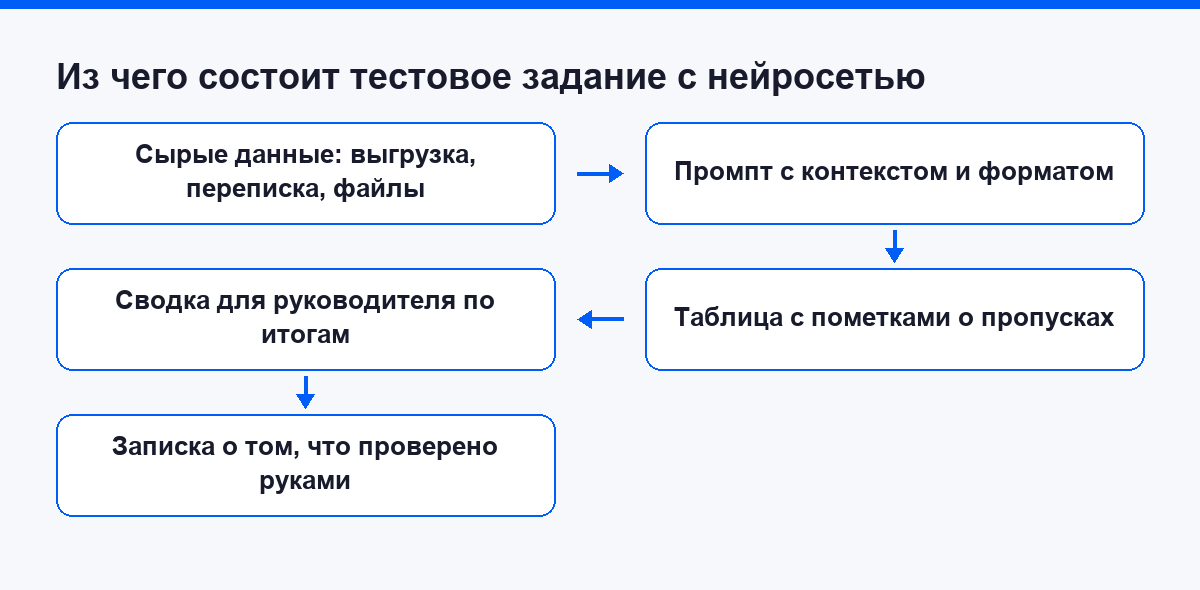
Типовое задание собрано из двух частей. Сначала разрозненные данные сводят в одну таблицу с заданными столбцами, потом таблицу сворачивают в короткую сводку для руководителя, пять строк и вывод. Времени дают немного, инструмент вы выбираете сами, показать нужно и результат, и путь к нему.
Формулировки требований в таких вакансиях повторяются почти дословно. «Умение пользоваться нейросетями в рабочих задачах» стоит в блоке «будет плюсом» у административных ролей. У редакторских добавляется фактчекинг и умение находить авторитетные источники. У профильных ролей список длиннее: системные инструкции, подбор примеров, генерация только по предоставленным материалам, разбор ошибок, сравнение версий промптов на одинаковых примерах.
Не помните, чем контекст отличается от системной инструкции? Термины на практике собраны в материале про основы работы с нейросетями. Та же лексика пригодится и в резюме, где навык описывают одной строкой, и её формулировки показывает статья про навык нейросетей в резюме.
В самом задании нет ничего специфического для найма. Так же выглядит обычная рабочая просьба свести данные, просто у неё появился зритель.
Как к такому заданию подходят на первом заходе?
Коротко: типовой первый заход выглядит так. Открывают чат, пересказывают задачу своими словами, вставляют кусок данных и просят «сделай таблицу и короткую сводку». Ответ приходит за минуту, выглядит аккуратно, столбцы на месте, сводка гладкая. Кандидат считает работу сделанной. На разборе выясняется, что разговор пойдёт про несходящиеся числа в файле.
Логика первого захода понятна. Задание про нейросеть, значит, надо показать скорость. Она и кажется главным доказательством навыка.
Промпт при таком подходе выходит коротким. «Вот данные из переписки и выгрузки, сведи их в таблицу по заказам и суммам, потом собери по ней сводку с итогами». Формат столбцов не задан, единицы измерения не оговорены, что делать с пропусками, не сказано.
Модель на такую формулировку отвечает всегда. Она не остановится и не спросит, чего не хватает, пока её об этом не попросят; недостающее достроит сама и подаст ровно тем же спокойным тоном, что и проверенное.
Отсюда же второй ход, ещё более быстрый. Данные вставляют скриншотом, копировать ничего не надо. Документация Anthropic по работе с изображениями прямо предупреждает, что подсчёт объектов на картинке приблизительный, а на мелких и повёрнутых изображениях модель ошибается чаще. Отсюда и съехавшие строки в таблице со скриншота.
Что идёт не так на первом заходе?
Коротко: таблица выглядит опрятно, но цифры в ней уже поехали. Общий промпт без контекста и формата заставляет модель достраивать недостающее самой, и делает она это уверенно. Справка OpenAI формулирует прямо: модель бывает уверена в неверном ответе и выдумывает цитаты, исследования и ссылки на несуществующие источники. Кандидат сдаёт красивый файл не глядя, и обсуждать на разборе оказывается нечего.
Провал складывается из трёх слоёв, и каждый по отдельности выглядит безобидно.
Первый слой незаметнее всех. В выгрузке часть строк идёт без суммы, а в таблице суммы появляются у всех, потому что пропущенное заполнено правдоподобным. Взялись эти числа из общего представления модели о том, как выглядят такие таблицы.
Дальше идёт уверенный тон. Официальный список ограничений ChatGPT называет это «Confidence isn’t reliability», то есть высокая уверенность в ответе не означает его надёжности; ошибка не подсвечена, оговорки нет, интонация та же, что у верных строк.
Третий слой самый тихий. Сводка опирается на эти цифры и повторяет их прописью, ошибка из таблицы переезжает в текст и получает второе подтверждение. Сама механика выдумки устроена одинаково во всех моделях и от бренда не зависит.
Требование «внимательность к фактам, датам, числам» стоит в вакансиях отдельной строкой. Файл, сданный не глядя, отвечает на это требование сам, и отвечает не в пользу кандидата. Сама ошибка при этом обсуждается спокойно, если кандидат нашёл её и назвал.
Как переделать работу за пять шагов
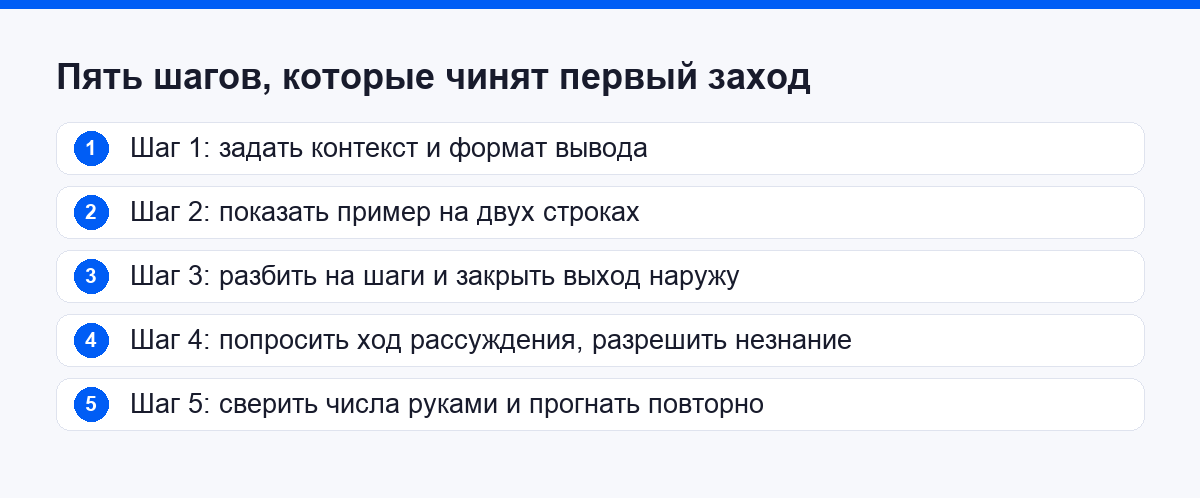
Коротко: второй заход начинается с того, что задача разбирается на части. Модели дают контекст, жёсткий формат вывода и пример на двух строках. Дальше идёт запрет выходить за пределы приложенных данных, просьба показать ход рассуждения и разрешение честно сказать «не знаю». Последний шаг остаётся человеку: числа сверяются руками по исходнику.
Порядок шагов ниже не изобретён блогом. Три из пяти прямо описаны в руководстве Anthropic по снижению галлюцинаций: работать только по приложенным материалам, разрешить ответ «не знаю» вместе с показом хода рассуждения, сверить между собой несколько прогонов. Оставшиеся два, контекст с форматом вывода и пример, руководство не разбирает, зато в вакансиях они стоят слово в слово — «структурированный вывод, обязательные поля, допустимые значения», «подбирать демонстрационные примеры и пограничные кейсы».
- Задайте контекст и формат вывода. Кто вы, что за данные, для кого таблица, какие столбцы, в каких единицах суммы, что писать в пустой ячейке. Формат задаётся до задачи, а не после первого неудачного ответа.
- Покажите пример на двух строках. Одна строка правильная, вторая пограничная: с пропуском, с двойной записью, с суммой в другой валюте. Пример работает лучше трёх абзацев объяснений.
- Разбейте на шаги и закройте выход наружу. Сначала извлечь строки, потом сверить, потом собрать таблицу. Отдельной фразой: пользоваться только приложенными материалами и не добирать ничего из общих знаний.
- Попросите показать ход рассуждения и разрешите незнание. Просьба писать «нет данных» вместо предположения снимает большую часть выдуманного. Ход рассуждения нужен вам, чтобы поймать, где модель свернула не туда.
- Сверьте числа руками и прогоните второй раз. Суммы и даты проверяются по исходнику глазами. Тот же промпт, запущенный повторно, показывает расхождения: там, где два прогона разошлись, скорее всего и сидит выдумка.
Отдельно про сам промпт. Разница между «сделай таблицу» и рабочей формулировкой разобрана на одном письме в материале как написать промпт для ChatGPT, а если чат вы открывали пару раз, начните с пошагового гайда для новичка без опыта.
Пять шагов занимают больше времени, чем один запрос. Работа удлиняется ровно на ту часть, которую потом и разбирают.
Что получилось со второго захода?
Коротко: второй заход занимает заметно больше времени, и в готовой таблице появляются пустые ячейки. Пустая ячейка здесь и есть результат: модель отметила, что данных нет, вместо того чтобы придумать число. Сводка опирается только на заполненные строки, а все спорные места вынесены отдельным списком вопросов к заказчику.
Готовый пакет получается из трёх файлов. Таблица с пометками там, где данных не хватило. Сводка, в которой нет ни одного числа без подтверждения. Короткая записка о том, как всё это собиралось.
Записку сдавать не просят, и именно она показывает ход работы. Внутри три абзаца — какой промпт использовался, что модель сделала неверно на первом заходе, что проверялось руками. Работодатель видит по ней ровно то, что стоит у него в требованиях: умение определить, связана ошибка с формулировкой промпта или с нехваткой контекста.
Часть задач при этом до модели не доходит вовсе, и список таких задач, где нужен человек, стоит держать под рукой заранее. Во втором заходе он и решает, что вы вообще отправляете в чат.
Было и стало: чем отличаются два захода
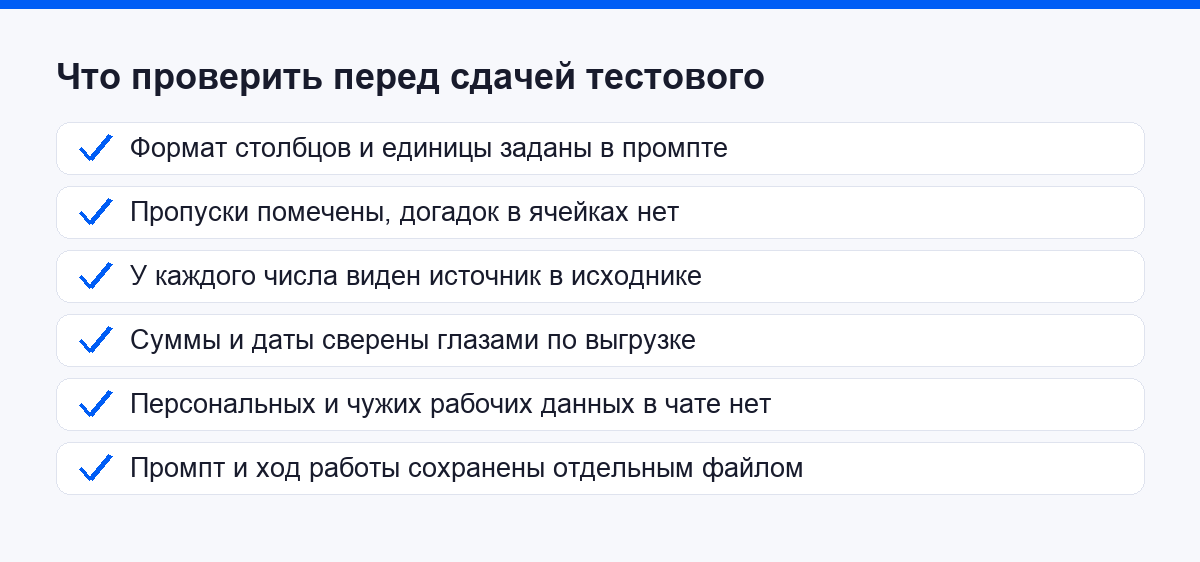
Коротко: внешне два файла похожи, разница видна на уровне проверяемости. В первом заходе нет ни одного места, где можно спросить «откуда это число». Во втором у каждой строки есть источник, у каждого пропуска пометка, а у сводки отдельный список того, что осталось на подтверждении заказчика. Эту разницу и разбирают на собеседовании.
| Что смотрят | Первый заход | Второй заход |
|---|---|---|
| Промпт | пересказ задачи в трёх строках | контекст, формат столбцов, пример на двух строках |
| Пропуски в данных | заполнены правдоподобным | помечены как отсутствующие |
| Источник числа | не отслеживается | указан для каждой строки |
| Ход рассуждения | скрыт | показан и прочитан человеком |
| Проверка руками | не проводилась | суммы и даты сверены по исходнику |
| Что сдаётся | один файл | таблица, сводка и записка о ходе работы |
Заметьте, чего в правом столбце нет. Там нет более сложного промпта на две страницы и нет другой модели. Всё, что изменилось, укладывается в контекст, формат, пример и проверку.
Разница в проверяемости объясняет, почему разговор на собеседовании быстро уходит от инструмента. Названия сервисов меняются каждый квартал, а порядок работы с ними держится годами. Проверить, что успело поменяться за год, можно в обзоре перемен в работе с нейросетями.
Правый столбец таблицы поэтому переносится на любую модель. Меняется интерфейс, а колонки остаются те же.
Что переносится на ваши рабочие задачи
Коротко: из тестового с нейросетью переносятся три привычки. Задавать формат вывода до того, как модель начнёт отвечать. Требовать источник под каждым числом и оставлять пропуск пустым. Держать под рукой список задач, которые вы модели не отдаёте. Эти же три вещи превращаются в спокойные ответы на разговоре о навыке.
Привычки работают не только в тестовом. Они одинаково ложатся на отчёт, на подбор поставщиков, на разбор договора и на сводку по проекту, потому что механика ошибки везде одна.
Отдельно переносятся заготовки. Один раз написанный промпт под сведение данных живёт дальше и экономит вход в каждую следующую задачу. Кажется, что собирать их незачем, но личная библиотека промптов окупается уже со второго повторения задачи.
Сохраняйте пары «до и после». Неудачный и рабочий промпт на одной задаче показывают навык нагляднее списка сервисов в резюме, и такие пары складываются в портфолио работ с нейросетями.
Систематически тему разбирают на онлайн-курсе «Работа с чат-GPT».
Какие вопросы про нейросети задают вокруг задания?
Коротко: разговор идёт по пяти осям. Границы применения, проверка фактов, работа с чужими данными, экономия времени и разбор собственной ошибки. Требование встречается уже не только на профильных ролях: слово «промпт» на замере 3 сентября 2026 стояло в тексте около 560 вакансий на hh.ru, и это снимок одного дня. Ответы на все пять собираются из одного сданного тестового, если вы сохранили промпт и записку о ходе работы.
Академичной формулировки ждать не стоит. Вместо «расскажите про галлюцинации моделей» спрашивают «а тут вы откуда цифру взяли». Смысл при этом один.
| Что спрашивают | Зачем это спрашивают |
|---|---|
| Где вы не станете применять нейросеть | понимаете ли вы границы ответственности |
| Как вы проверяете факты в ответе | есть ли у вас процедура вместо ощущения |
| Что делаете с рабочими документами | не утечёт ли через вас чужая информация |
| Сколько времени это экономит | считаете ли вы результат или повторяете рекламу |
| Что делали, когда ответ оказался неверным | отличаете ли ошибку промпта от нехватки контекста |
Строка про разбор собственной ошибки самая конкретная из пяти. Формулировка «определять, связана ли ошибка с формулировкой промпта или контекстом» стоит в требованиях профильных вакансий дословно, и разобранный вами провал первого захода отвечает на неё готовым примером.
Где вы не станете применять нейросеть?
Коротко: у этого вопроса есть ответ, опирающийся на документ. Правила использования OpenAI в силе с 29 октября 2025 запрещают автоматизировать ответственные решения в чувствительных областях без проверки человеком и перечисляют тринадцать таких областей: от медицины и права до кредитов, страхования и государственных услуг. Там же запрещены советы, требующие лицензии.
Ответ, опёртый на правила разработчика, звучит конкретнее общих слов про осторожность. Формулировка простая: вот область, где решение без человека запрещено самим поставщиком услуги.
Отдельная деталь для разговора о найме. Слово «employment» стоит в этом перечне прямо, и автоматический отбор резюме без участия человека попадает в тот же список, что медицина и кредитование.
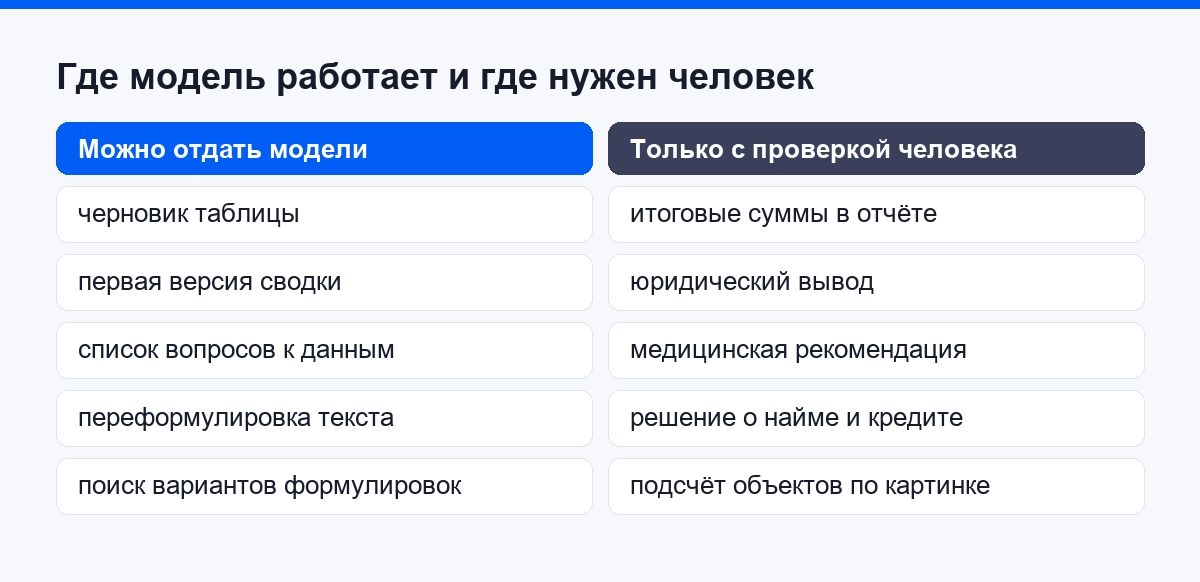
Дальше в ответе идёт документация по работе с изображениями. Anthropic перечисляет, чего модель не умеет: определить, сгенерирована ли картинка, точно посчитать объекты, надёжно разобрать некачественное, повёрнутое или очень мелкое изображение меньше 200 пикселей. Список короткий, его легко назвать вслух на интервью.
Самая короткая часть ответа личная. Назовите два случая из своей работы, где вы сознательно не пустили нейросеть, и объясните почему. Двух примеров хватает, третий уже ничего не добавляет.
Как вы проверяете факты в ответе?
Коротко: рабочий ответ описывает процедуру из трёх ходов. Требовать источник под каждым утверждением, запрещать выходить за пределы приложенных материалов, сверять числа руками. Руководство Anthropic добавляет приём для длинных документов: на объёме больше 20 тысяч токенов сначала просят выписать дословные цитаты и только потом делать выводы.
Порядок в ответе тут важнее полноты. Сначала назовите, что проверяете всегда: числа, даты, имена и ссылки на внешние документы. Потом скажите, чем проверяете. Исходником, официальной страницей, повторным прогоном.
Справка OpenAI отдельным пунктом называет выдуманные ссылки на несуществующие источники, и на интервью эту деталь стоит произнести вслух.
Есть готовая формулировка, за которой стоит документ разработчика. Ответ нейросети идёт в работу черновиком и окончательным источником не считается. Сама техника сверки по шагам разобрана в материале как проверять ответы: источники, логика, цифры.
Честная оговорка в ответе обязательна. Руководство Anthropic прямо пишет, что приёмы уменьшают выдумки, но полностью их не убирают, и кандидат, который произносит это сам, закрывает уточняющий вопрос заранее.
Что делать с конфиденциальными данными?
Коротко: сильный ответ описывает порядок работы. Настройка «не обучаться на моих данных» существует и переключается в разделе приватности, приватной переписку она при этом не делает. Справка Anthropic говорит прямо: после нажатия на палец вверх или вниз весь разговор сохраняется в защищённом хранилище на срок до пяти лет.
Ловушка с обратной связью незаметная, и на разговоре она работает как признак опыта. Человек выключил обучение на своих данных, поставил лайк удачному ответу и вернул весь разговор в хранение. Справка OpenAI описывает то же самое: после оценки ответа пальцем вверх или вниз весь связанный разговор может уйти в обучение моделей.
Отсюда простое рабочее правило. Пароли, ключи доступа и чужие персональные данные в чат не вводят независимо от настроек. С непубличными документами работодателя порядок другой: сначала выясняют внутренние правила компании, есть ли согласованный сервис и кто отвечает за такое решение. Если правил нет или они запрещают внешние сервисы, документ в чат не уходит совсем.
Разница между личным тарифом и рабочим тоже пригодится в разговоре. У OpenAI бизнес-продукты и API по умолчанию не обучаются на введённом, у личных тарифов обучение включено, пока пользователь не откажется. Что именно не стоит вводить в чат и по каким признакам это определяют, разбирает статья про безопасность данных в ChatGPT.
Такой ответ на собеседовании и ждут. Он показывает, что вы понимаете, чьё это решение, и не принимаете его за компанию сами.
Сколько времени экономит нейросеть и на чём?
Коротко: проверяемой средней цифры по экономии не существует, и называть её наугад опаснее, чем промолчать. Сильный ответ звучит иначе: назвать конкретную задачу, сказать, какой её кусок ушёл модели, и признать, что проверка результата осталась на человеке и времени тоже требует. Такой ответ выдерживает уточняющий вопрос, и это его главное свойство.
Полезно называть не только выигрыш, но и место, где время прибавилось. На сведении данных экономия идёт на черновике таблицы, а прибавляется на сверке чисел. Со сводкой то же самое, только быстрее пишется первая версия, а дольше вычитываются факты.
Честно назвать и срок освоения. Сколько времени уходит на каждый этап, посчитано в разборе за сколько осваивают ChatGPT.
Помогает и обратный ход, когда собеседник настроен скептически. Скажите, где модель вам мешала: на задачах с редкой терминологией, на свежих данных за пределами обучения, на подсчётах по картинке. Названное ограничение снимает подозрение, что вы пересказываете рекламу.
Какие ошибки в таком разговоре стоят дороже всего?
Коротко: дороже всего обходятся пять вещей. Сданная без проверки работа. Ответ «нейросеть умеет всё» без единой границы. Пересказ чужих данных из рабочей переписки прямо в чат. Разговор о названиях сервисов вместо разговора о самой задаче. И обещание точности, которую вы не измеряли и подтвердить ничем не можете.
Первая тяжелее остальных. Файл, сданный без проверки, не даёт разговору начаться, потому что обсуждать нечего, пока цифры не сверены.
Следом идёт отсутствие границ. Кандидат, у которого нейросеть подходит для всего, читается как человек, который ею не пользовался всерьёз. У того, кто работал, всегда есть список задач, куда он модель не пускает.
Тише всех выглядит третья. Человек в разговоре мимоходом описывает, как загружал в чат клиентскую базу или внутренний регламент, и подаёт это как удачный ход. Для нанимающей стороны такая реплика читается как описание будущей утечки, и дальше разговор идёт уже про внутренние правила компании.
Ещё одна ошибка живёт в лексике. Ответ, собранный из названий сервисов и модных слов, без единой рабочей задачи внутри, звучит как пересказ рекламы, а разговор держится на другом: задача, промпт, ошибка, проверка, результат.
Последняя выглядит скромнее прочих и обходится дороже, чем кажется. Обещание точности, которую вы не измеряли: «ошибок почти не бывает», «перепроверять уже не приходится». Один уточняющий вопрос собеседника, и обещание рассыпается.
Все пять чинятся одним и тем же. Сданной работой, в которой видно, что проверялось руками, и парой мест, где вы модель сознательно не пустили. Это ровно то, что собиралось во втором заходе: таблица с пометками, сводка без неподтверждённых чисел и записка о ходе работы. Ничего сверх этого на разговоре не понадобится.
Что ещё спрашивают на собеседовании про ИИ
Нужно ли признаваться, что резюме помогала писать нейросеть?
Прямого вопроса обычно не задают, зато фактуру проверяют охотно. Отвечать честно дешевле. Скажите, что черновик собран моделью, а факты, цифры и формулировки вы проверяли сами. Опасность прячется в несовпадении: в резюме навык описан пышно, а на разбор рабочей задачи человек ответить не может.
Что отвечать, если нейросетями пользовались только для учёбы и личных дел?
Говорить как есть и переводить в задачи. Учебный конспект, разбор непонятного текста, подготовка к экзамену, обращение в управляющую компанию — всё это годится как рабочий сценарий, просто вне офиса. Важнее показать процедуру проверки, место применения тут вторично.
Спросят ли про API, токены и внутреннее устройство моделей?
В требованиях к административным и редакторским ролям таких формулировок нет. Там достаточно понимать промпт, контекст и то, почему модель ошибается. Требования вроде структурированного вывода, работы с длинным контекстом и сравнения версий промптов встречаются у профильных ролей, где работа с моделью и есть содержание должности.
Что отвечать, если у работодателя нет доступа к зарубежному сервису?
Спокойно и по факту. Зарубежные сервисы публикуют списки поддерживаемых стран, России в них нет, подписка требует зарубежного платёжного средства. Внутри страны работают собственные модели со своими интерфейсами и документацией. Навык при этом переносится: промпт, контекст, проверка ответа и формат вывода устроены одинаково у любой модели, а разговор на собеседовании идёт про порядок работы.
Источники
- hh.ru, поиск по слову «нейросети» по тексту вакансий, Россия. Около 2 700 вакансий на замере 03.09.2026; счётчик пересчитывается в течение дня, точное число к моменту чтения будет другим
- hh.ru, поиск по слову «нейросети» по названиям вакансий, Россия. Около 300 вакансий на замере 03.09.2026; счётчик пересчитывается в течение дня, точное число к моменту чтения будет другим
- hh.ru, поиск по слову «промпт», Россия. Около 560 вакансий на замере 03.09.2026; счётчик пересчитывается в течение дня, точное число к моменту чтения будет другим
- OpenAI, правила использования. Запрет на автоматизацию ответственных решений в чувствительных областях без проверки человеком, в силе с 29.10.2025
- OpenAI, справка «Does ChatGPT tell the truth?». Виды галлюцинаций и рекомендация проверять цитаты, данные и ссылки
- Anthropic, руководство по снижению галлюцинаций. Приёмы проверки и оговорка про их пределы
- Anthropic, документация по работе с изображениями. Раздел ограничений: подсчёт объектов, мелкие изображения, сгенерированные картинки
- Anthropic, справка о данных и обучении моделей. Хранение переписки после обратной связи до пяти лет
- OpenAI, справка о том, как данные используются для улучшения моделей. Обучение на личных тарифах, отказ и временные чаты

